
Stable Diffusion
stable diffusion — семейство моделей генерации изображений
Stable Diffusion — семейство моделей для генерации изображений с доступными весами. Разберём локальный запуск, различия поколений и совместимость с LoRA и ControlNet. Лицензия зависит от конкретной модели.
Коротко
Stable Diffusion — семейство моделей для создания и редактирования изображений. Опубликованные веса позволяют запускать совместимую модель на своём компьютере, если хватает ресурсов и соблюдается лицензия. Вокруг семейства появились интерфейсы, расширения и большое сообщество авторов дообучений.
Что это такое
В 2022 году публикация ранних весов Stable Diffusion сделала качественную генерацию изображений доступной для локальных экспериментов. Вокруг моделей быстро выросли интерфейсы, расширения и сообщество авторов собственных дообученных моделей.
До появления открытых весов многие популярные генераторы изображений были доступны только через сервисы. Stable Diffusion предложила другой маршрут: модель можно было скачать, изучать и запускать на своей машине в пределах лицензии конкретного релиза. Это дало экосистеме локальные интерфейсы, дообучения и независимые исследовательские проекты.
Поколения модели:
- SD 1.x. Лёгкое поколение с большой коллекцией дообученных моделей, LoRA и расширений; обычно работает с меньшим разрешением и скромнее расходует память.
- SD 2.x. Отдельное поколение со своими энкодерами и вариантами предсказания; дополнения от SD 1.x не считаются автоматически совместимыми.
- SDXL. Более крупная архитектура, рассчитанная на больший базовый размер кадра и собственную экосистему совместимых дополнений. См. отдельную статью.
- SD 3.x. Ветка с MMDiT и другими текстовыми энкодерами. Требования, лицензия и совместимость зависят от точного релиза, поэтому название семейства здесь недостаточно.
У сообщества есть собственные дообученные варианты и смеси весов. Название проекта не заменяет сведения об архитектуре: разные его выпуски могут опираться на разные поколения. Один из таких путей подробно показан в истории Pony Diffusion: художественный отбор данных меняет характер модели и привычный способ составления промпта.
Как это работает
Добавление шума — не то же самое, что размытие. При обучении ранних диффузионных моделей исходные данные зашумляют и учат сеть предсказывать величину, помогающую восстановлению. При генерации сеть не проигрывает запись конкретной фотографии назад: по выученным закономерностям она помогает построить новое изображение.
У SD 3.x используется связанная постановка rectified flow: модель предсказывает направление движения между шумом и данными. Поэтому формула «все версии просто вычитают предсказанный шум» неточна.
Внутри Stable Diffusion четыре связанных компонента:
- VAE — кодирует картинку в компактное латентное представление и декодирует результат обратно. Размер латента зависит от архитектуры; работа в нём заметно снижает вычислительную нагрузку по сравнению с обработкой исходных пикселей на каждом шаге.
- Генеративная сеть — получает текущее зашумлённое состояние и делает прогноз для следующего шага. В SD 1.x, 2.x и SDXL это U-Net; в SD 3.x — трансформерная архитектура MMDiT. Тип прогноза зависит от модели.
- Текстовые энкодеры — превращают описание в числовые представления. Их набор различается по поколениям: это не всегда один CLIP.
- Sampler + Scheduler — численный маршрут от шума к латенту. Подходящее число шагов зависит от checkpoint, способа обучения и выбранного метода.
Пример на практике
Допустим, видеомонтажёру нужна обложка с рассветным городом. У него уже есть компьютер для локальной генерации, а платить за каждый пробный кадр не хочется.
Монтажёр запускает ComfyUI с совместимым SDXL-checkpoint и собирает базовый граф: текстовое описание, латент нужной формы, сэмплер и декодирование VAE. Сначала проверяет композицию на нескольких seed — стартовых числах генератора шума. Затем отдельно исправляет выбранные области и увеличивает изображение. Время зависит от модели, размера, шагов, точности вычислений и оборудования.
Не подошёл первый вариант — меняется seed, после серии проб остаются три кандидата. Выбранный кадр проходит через апскейлер и ручную проверку деталей. Локальный запуск не берёт плату за каждый запрос, но использует собственное оборудование, электричество и время; облачный переносит эти расходы в тариф сервиса.
Такой процесс можно собрать полностью локально, без очереди облачного сервиса. Но остаются ограничения оборудования и лицензий, а для повторяемости нужны точные настройки и совместимая среда. Если в графе есть облачные ноды, он уже не целиком локальный. Последовательная сборка процесса — от модели до локальных правок — разобрана в полном гиде по Stable Diffusion.
С чем часто путают
- Stable Diffusion и Stability AI — Stability AI — компания, а Stable Diffusion — семейство моделей. Stable Video Diffusion, Stable Audio и Stable Cascade — отдельные проекты; их компоненты не становятся совместимыми только из-за похожих названий.
- Stable Diffusion и Automatic1111 / ComfyUI — это модель, а Automatic1111 и ComfyUI — интерфейсы для её запуска. Для запуска нужны веса и программная реализация, но графический интерфейс необязателен: модель можно вызывать из кода.
- SD 1.5 и SDXL — разные поколения с несовместимыми весами. LoRA для SD 1.5 не работает в SDXL, и наоборот. Промпты тоже ведут себя по-разному.
- Stable Diffusion и FLUX — это разные семейства моделей с разной архитектурой, лицензиями и экосистемами дополнений. Качество и требования корректнее сравнивать на конкретных версиях и задачах.
Частые ошибки и заблуждения
- «Stable Diffusion полностью бесплатна для всего». У разных поколений, checkpoints и производных моделей могут быть разные лицензии. Возможность коммерческого применения проверяют по карточке точных весов и действующим условиям сервиса, а не по названию семейства.
- «Чем новее версия, тем лучше». Более новая архитектура может точнее понимать инструкцию, но требовать больше памяти или не поддерживать привычные LoRA и ControlNet. Полезнее сравнить кандидатов на одинаковых сценах и в том workflow, который нужен проекту.
- «Stable Diffusion не понимает русский». Качество зависит от поколения, текстовых энкодеров и дообучения. У многих вариантов английское описание предсказуемее, но утверждение обо всём семействе слишком широкое. Русскую и английскую формулировки можно сравнить на одной задаче.
- «Чтобы запустить SD, обязательно нужна флагманская видеокарта». Нет. Лёгкие или квантизованные варианты работают на более скромном оборудовании, а крупные можно запускать с переносом части данных в оперативную память либо в облаке. Практический предел зависит от точного checkpoint, размера кадра и терпимой задержки.
Связанные термины
- SDXL — отдельное поколение с собственными компонентами и примерно мегапиксельным рабочим масштабом базовой модели.
- FLUX — другое семейство генеративных моделей Black Forest Labs со своей архитектурой, лицензиями и экосистемой.
- VAE — кодирует/декодирует латент внутри Stable Diffusion.
- CLIP — модель, текстовую часть которой используют некоторые поколения Stable Diffusion.
- LoRA — лёгкий адаптер для тонкой настройки SD под стиль или объект.
- ControlNet — модуль для контроля композиции (поза, скетч, глубина).
- WebUI-интерфейсы — форма с вкладками и параметрами; поддержка конкретной архитектуры зависит от проекта и версии.
Частые вопросы
Какую версию SD выбрать на практике? Сначала смотрят на совместимость существующих LoRA и ControlNet, доступную память, лицензию и тип изображений. Старые ветки удобны богатой экосистемой и меньшим весом, новые могут лучше следовать сложной инструкции, но требуют другого workflow. Небольшой тестовый набор своих сцен полезнее универсального рейтинга.
Можно ли использовать Stable Diffusion коммерчески? Коммерческие права задаёт лицензия точного файла весов и могут различаться даже внутри одного семейства. Перед публикацией или передачей модели клиенту стоит открыть карточку нужного checkpoint и прочитать действующую лицензию; старое описание другого поколения её не заменяет.
Где скачать веса? Официальные веса и карточки моделей публикуются в репозиториях авторов, часто на Hugging Face. Дообучения сообщества встречаются на специализированных площадках. Способ загрузки зависит от интерфейса, но в любом случае важны происхождение файла, лицензия и контрольная сумма.
SD понимает руки и текст? Способность рисовать руки и надписи заметно различается между checkpoints и режимами генерации. Даже сильная модель может исказить длинный текст или мелкую анатомию, поэтому важные надписи обычно проверяют отдельно и при необходимости доводят редактированием или вторым проходом.
Сколько времени занимает одна картинка? Скорость измеряют на точном workflow после прогрева. На неё влияют размер кадра, sampler, число вычислений генеративной сети, точность чисел, вычислительная библиотека, VAE, ControlNet и другие адаптеры. Сравнение по одному названию видеокарты без этих условий мало что говорит.
Главное
Stable Diffusion — не одна модель, а семейство моделей и инструментов вокруг них. Поколения различаются архитектурой, требованиями к памяти, лицензиями и совместимыми дополнениями. ComfyUI помогает сохранить процесс в виде графа и повторить генерацию с теми же настройками.
Источники
Большие разборы по теме
Все разборы →
LoRA в ComfyUI: стиль, персонажи, ракурсы и обучение
LoRA помогает настроить стиль, внешность персонажа или отдельную задачу. Разберём подключение в ComfyUI, совместимость с моделью, силу влияния, слова-триггеры и сочетание нескольких…
Custom Nodes в ComfyUI: установка, обновление и диагностика
Custom Nodes добавляют в ComfyUI новые узлы и целые наборы инструментов. В ComfyUI ими управляет встроенный Manager: он помогает найти пакет, установить…
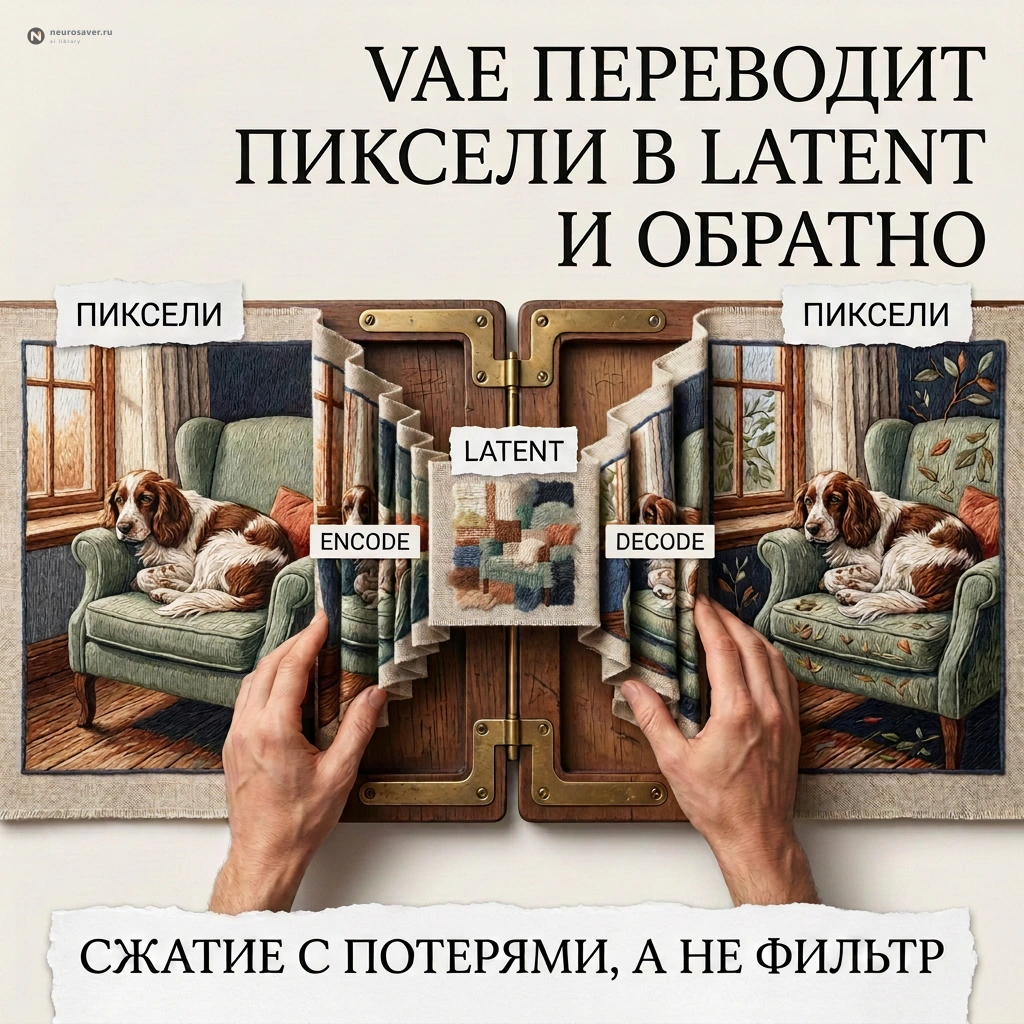
VAE в ComfyUI: откуда берутся серый кадр и странные цвета
После смены модели картинка стала серой или размытой? Проверим цепочку VAE Encode и Decode, сравним совместимые декодеры и отделим ошибки VAE от…
