SDXL
stable diffusion xl — семейство латентных диффузионных моделей Stability AI
SDXL (Stable Diffusion XL) — поколение Stable Diffusion, рассчитанное на изображения примерно мегапиксельного масштаба. Оно использует два текстовых кодировщика, дополнительное условие размера и необязательный refiner. Точные настройки зависят от checkpoint и способа ускорения.
Коротко
SDXL — семейство Stable Diffusion с опубликованными весами. Оно создаёт изображение в латентном пространстве — сжатом внутреннем представлении, которое затем преобразуется в пиксели. По сравнению с SD 1.x у базовой SDXL крупнее сеть удаления шума, два текстовых кодировщика и больший рабочий размер. Это отдельное семейство: LoRA, ControlNet и VAE должны быть совместимы именно с SDXL.
Что такое SDXL
Stable Diffusion XL была опубликована Stability AI как следующее поколение после SD 1.x и SD 2.x. В исходном выпуске представлены две модели:
- Base создаёт композицию и основное изображение;
- Refiner может принять промежуточный latent и доработать детали на поздней части denoising.
Refiner не обязателен. Многие дообученные checkpoints рассчитаны на полный проход одной моделью, а отдельные workflow используют другой способ детализации.
Что изменилось по сравнению с SD 1.5
Более крупный denoiser
Основная сеть SDXL заметно больше. Вместе с другими изменениями архитектуры и обучения это помогло улучшить результаты по сравнению с предшественниками, но сложные композиции всё равно могут не получаться. Более крупная сеть обычно требует больше памяти и вычислений. Реальная скорость зависит от реализации, точности, разрешения и устройства.
Два текстовых кодировщика
SDXL соединяет представления двух CLIP-энкодеров. Это даёт более богатое условие для генерации, но не отменяет ограничений: длинный промпт может размыть приоритеты, а точный текст внутри картинки остаётся отдельной сложной задачей.
Условие размера и кадрирования
Модель получает сведения об исходном размере, целевом размере и кадрировании. Эти параметры влияют на композицию и объясняют, почему одинаковый prompt при разных настройках может давать не просто более крупную копию.
Мегапиксельный рабочий масштаб
Обучение SDXL ориентировано примерно на площадь изображения около мегапикселя. Квадрат 1024 × 1024 — известная точка отсчёта, но не единственный допустимый формат. Подходят и другие соотношения сторон с близкой площадью, если их поддерживает workflow.
Как проходит генерация
Для базовой SDXL последовательность выглядит так:
- Промпт кодируется двумя текстовыми энкодерами.
- Программа готовит начальное зашумлённое состояние нужного размера.
- Сеть прогнозирует шум с учётом текста и параметров размера, а сэмплер обновляет состояние по выбранному расписанию.
- Генерация завершается базовой моделью либо на согласованной поздней границе продолжается совместимым refiner.
- VAE декодирует итоговое латентное представление в пиксели.
- Готовую картинку при необходимости увеличивают или локально редактируют отдельным проходом.
Есть и другой способ использовать refiner: частично зашумить уже завершённый результат base и доработать его. Это отдельный проход, а не то же самое, что переключение моделей внутри одной траектории. В ComfyUI нода Empty Latent Image сама шум не создаёт: его подготавливает этап сэмплирования.
Каждый компонент влияет на результат. «SDXL» без названия checkpoint, VAE и workflow описывает только семейство.
Base, fine-tune и LoRA
Base checkpoint удобен как исходная точка и для обучения адаптеров. Fine-tuning — дообучение под определённые задачи или данные. Оно может обновлять сами веса модели либо использовать компактные адаптеры, такие как LoRA. На площадках словом fine-tune часто называют готовый дообученный чекпойнт.
Сторонняя модель с пометкой XL может иметь собственные рекомендации по промпту, CFG, sampler и VAE. Настройки от другой модели не обязаны переноситься без изменений.
Ускоренные варианты
Turbo, Lightning, LCM и другие дистиллированные или ускоренные варианты уменьшают число шагов, но делают это разными способами. Они могут требовать особого scheduler, CFG или LoRA.
Фраза «меньше шагов при том же качестве» слишком грубая. Ускорение меняет характер ошибок и гибкость управления. Кандидаты сравниваются на одинаковых seed, размерах и задачах.
Наглядный пример
Допустим, дизайнер готовит вертикальную иллюстрацию для статьи. Он начинает с совместимого SDXL-checkpoint и сохраняет seed.
Сначала проверяет композицию на рабочем размере. Затем меняет только один фактор за раз: prompt, CFG или sampler. Выбранный кадр уточняет inpainting, а увеличение делает отдельным этапом.
Так видно, что именно улучшило результат. Если одновременно сменить модель, seed и другие параметры, причину улучшения будет трудно установить.
SDXL в ComfyUI
Базовый граф включает загрузчик checkpoint, кодирование положительного и отрицательного prompt, latent нужного размера, sampler и VAE Decode. Для refiner нужен второй checkpoint и передача latent на позднюю часть процесса.
Совместимость важнее названия ноды:
- SDXL LoRA подключается к SDXL-модели;
- ControlNet должен быть обучен для подходящей архитектуры;
- refiner получает корректно подготовленный latent;
- ускоряющий адаптер используется с рекомендованным scheduler;
- размер изображения выбирается с учётом обучающего распределения.
Встроенный Manager ComfyUI помогает находить и обновлять custom nodes, но не проверяет художественную или архитектурную совместимость workflow автоматически.
Память и скорость
Требования зависят от устройства, вычислительной библиотеки, точности чисел, размера кадра, числа изображений в пакете и одновременно загруженных моделей. Выгрузка компонентов в оперативную память (offload) и обработка изображения VAE по участкам (tiled VAE) уменьшают пиковую потребность в видеопамяти. При этом возможны дополнительные передачи данных, затраты времени, а у обработки по участкам — артефакты на границах.
Вместо универсальной таблицы полезнее запустить точный workflow и измерить:
- пиковую память;
- время первого и повторного кадра;
- качество при выбранном размере;
- влияние refiner и дополнительных сетей.
С чем часто путают
- SDXL и любой checkpoint с XL в названии. Буквы в названии не доказывают происхождение. Совместимость подтверждают карточка и архитектура модели.
- Base и refiner. Это разные этапы; второй не обязателен.
- Native 1024 и строгий квадрат. Речь о рабочем масштабе, а не об одном формате.
- Ускорение и обычный checkpoint с малым числом шагов. Дистиллированная модель обучена для такого режима, базовая — не обязательно.
- Большее разрешение и больше деталей. Слишком крупный latent может разрушить композицию или повторить объекты.
Частые ошибки
- Подключать LoRA или ControlNet от другой архитектуры.
- Переносить preset Base на Turbo или Lightning без проверки.
- Использовать случайный VAE только ради более насыщенных цветов.
- Считать refiner обязательным для любого изображения.
- Сразу генерировать финальный огромный кадр вместо отдельного upscale.
- Оценивать модель по одному удачному seed.
Частые вопросы
Когда SDXL подходит для задачи?
Когда подходят доступные чекпойнты, адаптеры, лицензия и возможности оборудования. Возраст архитектуры сам по себе не определяет пользу.
Нужен ли refiner?
Только если он улучшает конкретный checkpoint и workflow. Это проверяется парным сравнением, а не названием модели.
Какое разрешение выбрать?
Начать с размеров, близких к мегапиксельному обучающему масштабу и нужному соотношению сторон. Точные значения лучше взять из карточки checkpoint и проверить на серии seed.
Почему настройки из чужого workflow не работают?
Могут отличаться checkpoint, VAE, sampler, scheduler, версия custom node и способ кодирования prompt. Для воспроизводимости нужны все эти данные.
Главное
SDXL — не один художественный стиль, а семейство базовых моделей, дообученных вариантов и адаптеров. Совместимость внутри него тоже требует проверки. Её сильная сторона — зрелые локальные workflow и широкий контроль. Хороший результат начинается с совместимых компонентов и измеримого сравнения, без ожидания, что один набор настроек подойдёт для всех вариантов.
Источники
Большие разборы по теме
Все разборы →
LoRA в ComfyUI: стиль, персонажи, ракурсы и обучение
LoRA — это небольшой адаптер, который помогает менять стиль, удерживать персонажа, добавлять узкую задачу или подталкивать модель к нужному ракурсу. В ComfyUI…

Custom Nodes в ComfyUI: установка, обновление и диагностика
Custom Nodes добавляют в ComfyUI новые узлы и целые наборы инструментов. В ComfyUI ими управляет встроенный Manager: он помогает найти пакет, установить…
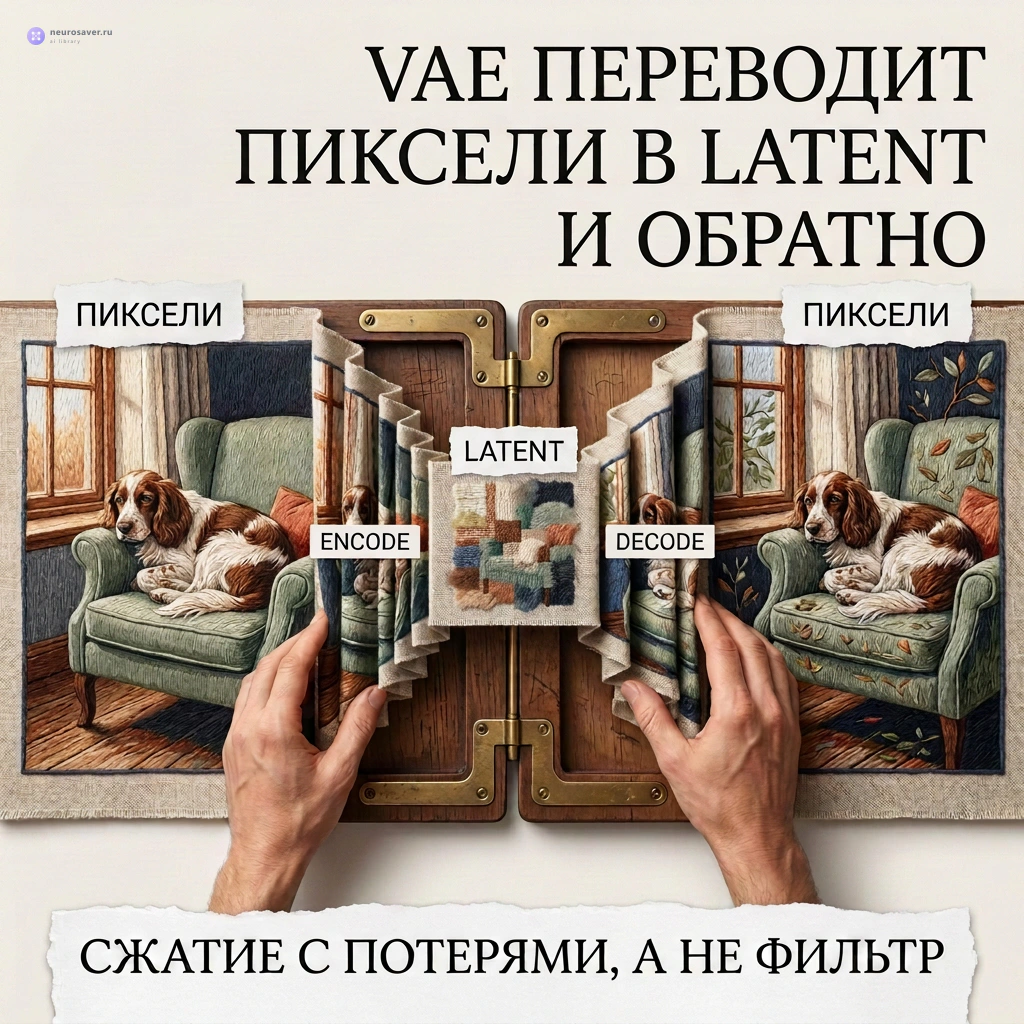
VAE в ComfyUI: откуда берутся серый кадр и странные цвета
VAE в ComfyUI — это модель-переводчик между пикселями и латентным представлением. VAE Encode превращает изображение в latent для img2img и inpainting, а…