LoRA
low-rank adaptation — настройка модели через компактные обновления весов
LoRA позволяет адаптировать модель к задаче, обучая небольшие добавки к выбранным весам вместо полного набора параметров. В генерации изображений так настраивают стиль, персонажа или объект; в языковых моделях — поведение и работу с текстом. Адаптеру нужна совместимая база, а качество зависит от данных и обучения.
Коротко
LoRA — Low-Rank Adaptation, низкоранговая адаптация. Это способ дообучения, при котором исходные веса обычно остаются замороженными, а рядом обучаются компактные матрицы поправок. Их можно хранить отдельно и подключать к совместимой модели.
LoRA не ограничивается изображениями. Исходная работа была посвящена языковым моделям; тот же принцип применяют для персонализации генерации и других задач.
Зачем нужен отдельный адаптер
Представим, что одна базовая модель нужна для нескольких стилей иллюстрации. Полное дообучение создаёт отдельный большой набор весов для каждого варианта. С LoRA можно хранить одну базу и несколько небольших обновлений.
Это экономит место и память, необходимую для обучения параметров и состояния оптимизатора. Но базовая модель всё равно участвует в вычислениях, а промежуточные данные тоже занимают память. Поэтому маленький файл адаптера не означает, что обучение поместится на любом устройстве.
Размер и время работы зависят от архитектуры, выбранных слоёв, ранга, точности чисел и данных. Обещание «любая LoRA обучается за час» здесь не подходит.
Как устроена поправка к весам
Возьмём матрицу весов W размером 1024 × 1024. В ней 1 048 576 чисел. Вместо изменения всех этих значений можно обучать две матрицы:
A: 8 × 1024;B: 1024 × 8.
Вместе в них 16 384 числа — в 64 раза меньше. Их произведение B × A имеет ту же форму, что и W, но ранг не выше 8.
Упрощённая формула для выбранного слоя:
новые веса = исходные веса + scale × B × A
Здесь приближается обновление, а не сама базовая матрица. Адаптеры также не обязаны стоять в каждом слое: набор обучаемых модулей выбирает конфигурация.
В классической LoRA масштаб обучения связан с отношением alpha / rank. При использовании готового адаптера интерфейс может добавлять отдельный множитель strength. Эти настройки не стоит смешивать: тренировочный alpha и ползунок силы загруженной LoRA — не одно и то же.
Что означает rank
Ранг задаёт размер промежуточного представления матриц поправки. При прочих равных больший ранг увеличивает число обучаемых параметров и размер файла.
Это даёт обновлению больше свободы, но не гарантирует более красивое лицо или точный текст. Если данных мало, подписи неудачны или обучение настроено неправильно, увеличение ранга не решит проблему. Сравнивать его полезно по проверочным задачам, а не по принципу «больше значит лучше».
Пример: один персонаж в разных сценах
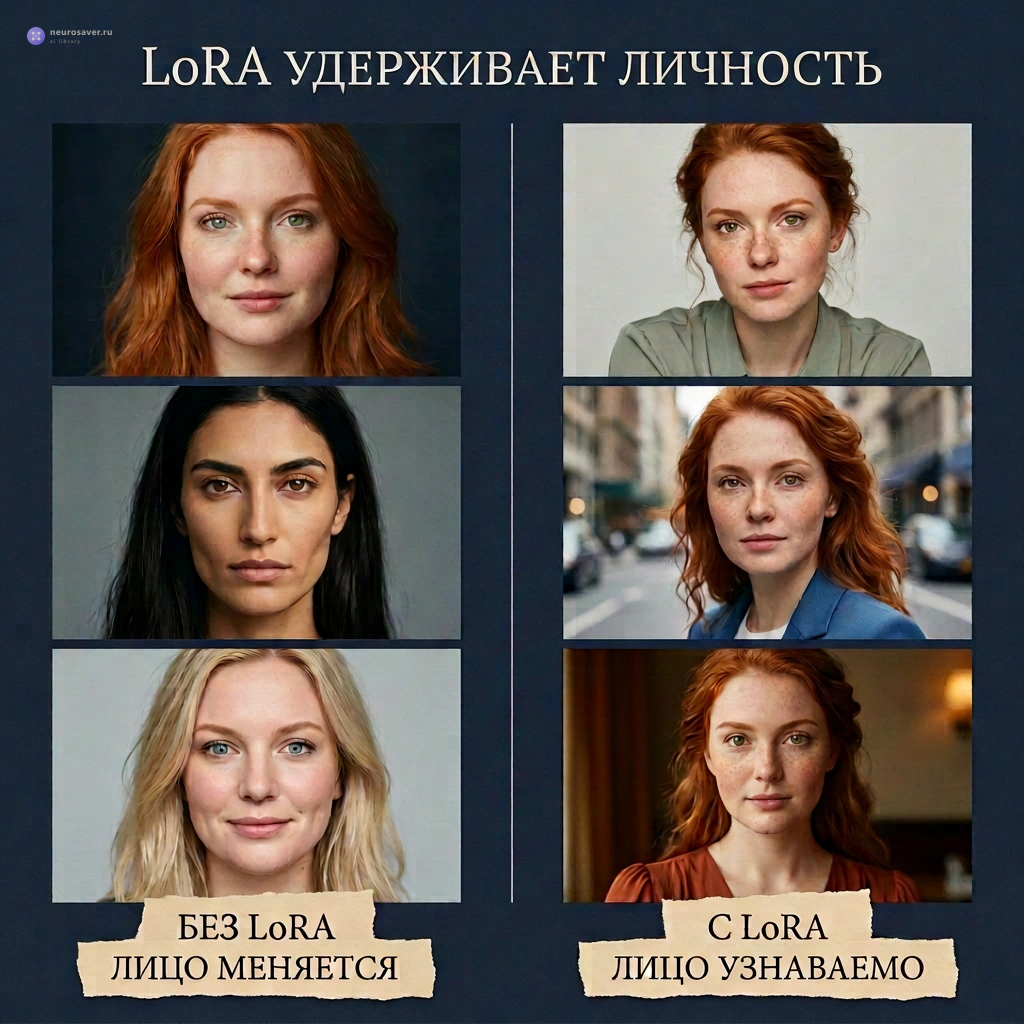
Допустим, для иллюстраций нужен узнаваемый персонаж: у окна, на улице и за рабочим столом. Без персонализации модель может менять черты лица от кадра к кадру. LoRA помогает выучить устойчивые особенности, но не гарантирует полное совпадение.
Для обучения важны разные ракурсы, выражения и условия съёмки. Если на всех изображениях одна куртка и один фон, модель может связать их с персонажем. Подписи помогают различать признаки, но сами по себе не компенсируют однообразную подборку.
Проверочные сцены лучше отличать от обучающих. Сходство лица оценивают отдельно от качества всего кадра: красивая иллюстрация может изображать другого человека, а точное лицо — повторять исходную позу и фон слишком буквально.
Для стиля логика похожа. Разные сюжеты помогают отделить художественную манеру от предметов, которые случайно встречались в примерах.
Как подобрать силу готовой LoRA
Сила адаптера масштабирует выученное обновление. Это не процент сходства и не универсальный показатель качества.
Удобно начать с настроек автора для совместимой базы, затем сравнить несколько значений при одинаковых промпте и seed. После этого — проверить выбранное значение на других сюжетах и нескольких seed. Иначе удачная настройка может оказаться удачной только для одного кадра.
Если сила слишком велика для данной связки, могут появиться повторяющаяся композиция, чужие детали из обучения, чрезмерный контраст или артефакты. Если слишком мала — нужный признак почти не проявится. Фиксированного «правильного диапазона для всех лиц» нет.
Совместимость с базовой моделью
Адаптер должен соответствовать архитектуре, именам и формам целевых слоёв, а также способу загрузки. LoRA для SD 1.5 не становится адаптером для SDXL или FLUX от переименования файла.
При этом разные дообученные варианты одной совместимой базы могут использовать одну LoRA. Результат не обязан совпадать: собственная настройка checkpoint уже изменила поведение модели.
Полезная карточка адаптера указывает базу, поддерживаемые загрузчики, обучаемые компоненты, примеры и условия использования. Совпадение расширения .safetensors не доказывает совместимость.
Подключение в ComfyUI
В типовой схеме Stable Diffusion нода Load LoRA принимает модель и текстовый энкодер от загрузчика checkpoint. Её выход MODEL идёт к KSampler, а выход CLIP — к нодам кодирования текста. VAE проходит отдельно.
Если адаптер обучал текстовый энкодер, но промпт кодируется исходным CLIP, часть настройки не участвует в результате. В других архитектурах набор загрузчиков и обучаемых компонентов может отличаться.
Несколько совместимых LoRA можно подключить цепочкой. Для интерфейсов, поддерживающих синтаксис AUTOMATIC1111, встречается запись <lora:name:strength>; в ComfyUI одна такая строка в промпте не заменяет подключение ноды.
Несколько адаптеров и слияние
Обычные LoRA могут складывать обновления одних и тех же весов с разными коэффициентами. Но результат нелинейной нейросети не равен сумме готовых картинок или стилей.
Нет правила, что после двух адаптеров всё обязательно ломается. Важно, что они меняют и насколько совместимы их цели. Для поиска конфликта полезно проверить каждый отдельно, затем пару и только потом добавлять остальные.
Слияние бывает разным:
- объединение нескольких обновлений в один адаптер;
- включение обновления в полные веса базовой модели.
Во втором случае получается файл полной модели, а не маленькая LoRA. Если адаптер нужен для дальнейшего переключения, его исходную копию и базу стоит сохранить отдельно. Способы слияния и точность результата зависят от инструмента.
С чем часто путают
Полное дообучение. Оно меняет основные веса. LoRA — один из способов параметрически эффективного дообучения, при котором обучаемых значений меньше.
DreamBooth. Это подход к персонализации по примерам, который можно сочетать как с полным дообучением, так и с LoRA. Это не два взаимоисключающих уровня качества.
Textual Inversion. Обычно обучает одно или несколько векторных представлений понятия для текстового энкодера. LoRA меняет поведение выбранных слоёв через поправки к весам.
LyCORIS и LoHa. LyCORIS — проект с несколькими методами адаптации, а LoHa — один из них. Это не просто «LoRA следующего поколения, которая всегда точнее».
IP-Adapter. Получает изображение-референс во время генерации. Для новой LoRA сначала нужны обучение и подготовка адаптера под задачу.
Частые вопросы
Сколько изображений нужно?
Универсального числа нет. Важны разнообразие, качество и то, насколько повторяемый признак отделён от фона, одежды и позы. Дополнительные почти одинаковые кадры могут дать меньше пользы, чем несколько хорошо подобранных отличающихся примеров.
LoRA может научить модель новому?
Да, это дообучение, а не просто указатель внимания. Оно может улучшить работу с конкретным понятием или задачей. Но возможности ограничены базой, данными и ёмкостью обновления; исправление всех ошибок модели не гарантируется.
Нужен ли trigger word?
Зависит от того, как адаптер обучали. Слово-триггер помогает вызвать выученное понятие, если такая связь была задана в обучении. Само произвольное слово не активирует специальную способность.
Почему LoRA похожа на обучающие фотографии, но плохо работает в новых сценах?
Возможны переобучение и слишком тесная связь персонажа с одеждой, ракурсом или фоном. Также влияют база и сила адаптера. Проверка на непривычных сценах помогает заметить проблему.
Можно ли выключить LoRA?
Отдельно загруженный адаптер обычно можно отключить или убрать из схемы. Если обновление уже включено в полные веса, для надёжного возврата понадобится исходная база или поддерживаемый инструментом способ отмены слияния.
Главное
LoRA сохраняет выученную поправку к выбранным весам модели в компактной форме. Она помогает настраивать стиль, персонажа или работу с текстом, но нуждается в совместимой базе. Данные, ранг и обучение определяют, что адаптер выучил; сила при использовании — насколько заметно это проявится.
Источники
Большие разборы по теме
Все разборы →
AI в кино: новые визуальные эффекты и живая актёрская игра
AI позволяет менять окружение, предметы и облик персонажей в снятом видео, используя исходную сцену и референсы. Но убедительный кадр ещё не означает…
LoRA в ComfyUI: стиль, персонажи, ракурсы и обучение
LoRA — это небольшой адаптер, который помогает менять стиль, удерживать персонажа, добавлять узкую задачу или подталкивать модель к нужному ракурсу. В ComfyUI…

Custom Nodes в ComfyUI: установка, обновление и диагностика
Custom Nodes добавляют в ComfyUI новые узлы и целые наборы инструментов. В ComfyUI ими управляет встроенный Manager: он помогает найти пакет, установить…