Fine-tuning
fine-tuning — дообучение готовой модели под задачу
Файнтюнинг дообучает готовую модель под свою задачу. Он помогает закрепить стиль или формат ответа. Разберём разницу между полным дообучением и LoRA, а также случаи, когда вместо обучения полезнее поиск по документам.
Коротко
Fine-tuning — дополнительное обучение уже подготовленной модели. Вместо старта со случайных весов берут базу с общими способностями и показывают ей примеры нужного поведения. Результат зависит от качества и разнообразия данных не меньше, чем от метода обновления параметров.
Что меняется в модели
Во время дообучения вычисляют ошибку модели и с помощью обратного распространения находят, как менять обучаемые параметры. Разница в исходной точке и масштабе задачи: базовая модель уже знает общие закономерности, а дообучение смещает её в нужную область.
Для языковой модели это может быть:
- устойчивый формат ответа;
- терминология компании;
- классификация обращений;
- стиль диалога;
- выполнение узкой инструкции.
Для визуальной модели — персонаж, материал, предмет, стиль съёмки или тип композиции.
Полное дообучение и адаптеры
Полное дообучение
При полном дообучении обновляют все основные обучаемые веса выбранной модели. Можно дообучать и только часть исходных слоёв — это уже частичный вариант. Обновление всей модели даёт больше свободы, но обычно требует больше памяти и вычислений, а также проверки, не потеряла ли база полезные способности.
LoRA
Базовые веса остаются неизменными, а к выбранным слоям добавляются небольшие обучаемые матрицы. После обучения адаптер можно хранить и подключать отдельно. Его размер зависит от ранга, числа затронутых слоёв и архитектуры.
QLoRA
База хранится в пониженной точности, а адаптер обучается поверх неё. Это уменьшает требования к памяти, но не делает любой запуск одинаково дешёвым: важны длина последовательности, размер батча, оптимизатор и поддержка операций на устройстве.
Другие PEFT-методы
Parameter-Efficient Fine-Tuning — общее название способов дообучения с небольшим числом изменяемых или добавленных параметров. Небольшое число параметров не означает, что изменится лишь небольшая часть поведения. Конкретные форматы различаются, и адаптер от одной архитектуры нельзя автоматически переносить на другую.
Когда fine-tuning подходит
Он особенно полезен, если одна и та же закономерность повторяется во множестве запросов:
- ответы должны иметь стабильную структуру;
- модель путает близкие классы;
- нужен узнаваемый визуальный персонаж;
- длинная инструкция постоянно занимает контекст;
- есть качественные пары «вход → желаемый ответ»;
- результат можно измерить на независимом наборе.
Если задача возникает один раз, дешевле начать с промпта. Если знания часто меняются, удобнее поиск или RAG. Если нужна новая функция приложения, fine-tuning не заменит обычный код и инструменты.
Fine-tuning, RAG и prompt engineering
| Задача | Подход |
|---|---|
| Объяснить формат и критерии одного ответа | Prompt |
| Подтянуть актуальные документы и цитаты | RAG |
| Закрепить повторяющийся стиль или поведение | Fine-tuning |
| Выполнить действие во внешней системе | Tool calling |
Эти методы можно сочетать. Дообученная модель может получать свежие документы через RAG и вызывать инструменты по строгой схеме.
Данные важнее объёма как такового
Полезный датасет показывает не только идеальные случаи. В нём нужны:
- типичные запросы;
- сложные границы между классами;
- примеры корректного отказа;
- разные формулировки одного намерения;
- для обучения на предпочтениях — сравнения удачных и неудачных ответов;
- данные, похожие на реальную эксплуатацию.
При обычном обучении на эталонных ответах неудачный ответ нельзя подавать как желаемый. Формат данных должен соответствовать цели обучения.
Дубликаты создают иллюзию большого корпуса и усиливают случайные детали. Противоречивые ответы учат модель колебаться. Секреты и персональные данные могут запомниться, поэтому права и очистка проверяются до обучения.
Как готовят эксперимент
- Описывают поведение, которое должно измениться.
- Проверяют исходную модель без дообучения, чтобы получить точку сравнения.
- Разделяют данные по источникам или сущностям, чтобы избежать утечки.
- Выбирают небольшой набор настроек.
- Сохраняют промежуточные версии.
- Выбирают вариант на валидационной выборке, затем один раз оценивают итог на отдельной тестовой.
- Проверяют, не ухудшились ли базовые способности.
Если одновременно сменить данные, промпт, базу и параметры, будет трудно понять, что помогло. Поэтому небольшие изменения удобнее сравнивать по отдельности.
Что проверять у языковой модели
- выполнение инструкции;
- формат и парсинг;
- точность классификации;
- устойчивость к новым формулировкам;
- поведение на запросах вне области;
- фактическую аккуратность;
- сохранение нужных общих способностей;
- безопасность на нежелательных сценариях.
Средняя метрика может скрыть редкую, но дорогую ошибку. Для важных классов полезен отдельный разбор ложных срабатываний и пропусков.
Что проверять у визуального адаптера
Один красивый кадр мало говорит о качестве. Контрольная сетка меняет:
- ракурс и крупность;
- свет и фон;
- одежду и окружение;
- выражение лица;
- стиль и композицию;
- запросы, на которые адаптер не должен заметно влиять.
Хорошая LoRA передаёт нужное свойство и оставляет модели свободу. Переобученный адаптер тянет один фон, позу или одежду во все сцены.
Основные риски
Забывание прежних навыков
Модель слишком сильно смещается и теряет часть прежних навыков. Риск снижают меньшим шагом, смешиванием данных, адаптерным методом и проверкой прежних задач после обновления.
Переобучение
На обучающих примерах результат прекрасен, а новая формулировка ломает поведение. Здесь помогают независимые данные и разнообразие, а не просто больше эпох.
Запоминание чувствительных данных
Модель может воспроизвести редкий фрагмент. Секреты лучше не включать в датасет, а персональные данные обрабатывать по понятным правилам удаления и доступа.
Смещение целей
Модель оптимизирует то, что показано в примерах. Если оценщики поощряли длинные уверенные ответы, fine-tuning может усилить многословие и самоуверенность вместо пользы.
Стоимость и время
На стоимость и время влияют:
- размер и архитектура базы;
- число обучаемых параметров;
- длина и объём данных;
- размер батча и накопление градиента;
- точность вычислений;
- оборудование и программная среда;
- число экспериментов и проверок.
Поэтому оценку бюджета делают на небольшом пробном запуске и масштабируют по измеренному расходу.
Частые ошибки
- Дообучать ради свежих фактов. Весам трудно обеспечить точное и быстрое обновление базы знаний.
- Не проверять исходную модель. Потом непонятно, помогло ли обучение вообще.
- Смешивать test с подбором настроек. Финальная оценка становится оптимистичной.
- Считать больше данных автоматически лучшими. Шум и противоречия тоже обучаются.
- Использовать несовместимый адаптер. Архитектура, слои и текстовый энкодер должны совпадать.
- Проверять только среднее качество. Редкие опасные ошибки остаются незаметны.
Частые вопросы
Fine-tuning добавляет модели новые знания? Он может закрепить информацию из датасета, но не даёт надёжной обновляемой базы фактов. Для документов с версиями и источниками лучше подходит поиск с передачей найденного в контекст.
Сколько примеров нужно? Универсального числа нет. Однородный формат может освоиться на компактном чистом наборе, а широкий домен потребует намного больше разнообразия. Полезнее строить кривую качества по мере добавления данных.
Можно ли объединять несколько LoRA? Да, если их поддерживает одна схема запуска и они совместимы с базой. Адаптеры могут конфликтовать, поэтому сочетание проверяют отдельно и не трактуют коэффициент как буквальный процент свойства.
Нужно ли дообучать самую большую модель? Нет. Компактная база может лучше подходить по задержке, стоимости и развёртыванию. Выбор делают по контрольной задаче и ограничениям системы.
Главное
Fine-tuning закрепляет повторяющееся поведение в параметрах модели. Он полезен для формата, стиля и специализации, но не заменяет свежие источники, инструменты и программную логику. Надёжный результат начинается с понятной цели, чистых данных, сравнения с исходной моделью и независимой проверки того, что модель приобрела нужное, не потеряв важное старое.
Устройство адаптеров описано в документации PEFT, а обучение поверх квантованной базы — в работе QLoRA.
Большие разборы по теме
Все разборы →
Одно лицо, разные миры: как обучить свою LoRA на Krea 2
Свой персонаж, узнаваемая манера иллюстрации или целая коллекция предметов требуют разных обучающих наборов. Разбираем, как подготовить изображения и подписи, обучить и проверить…
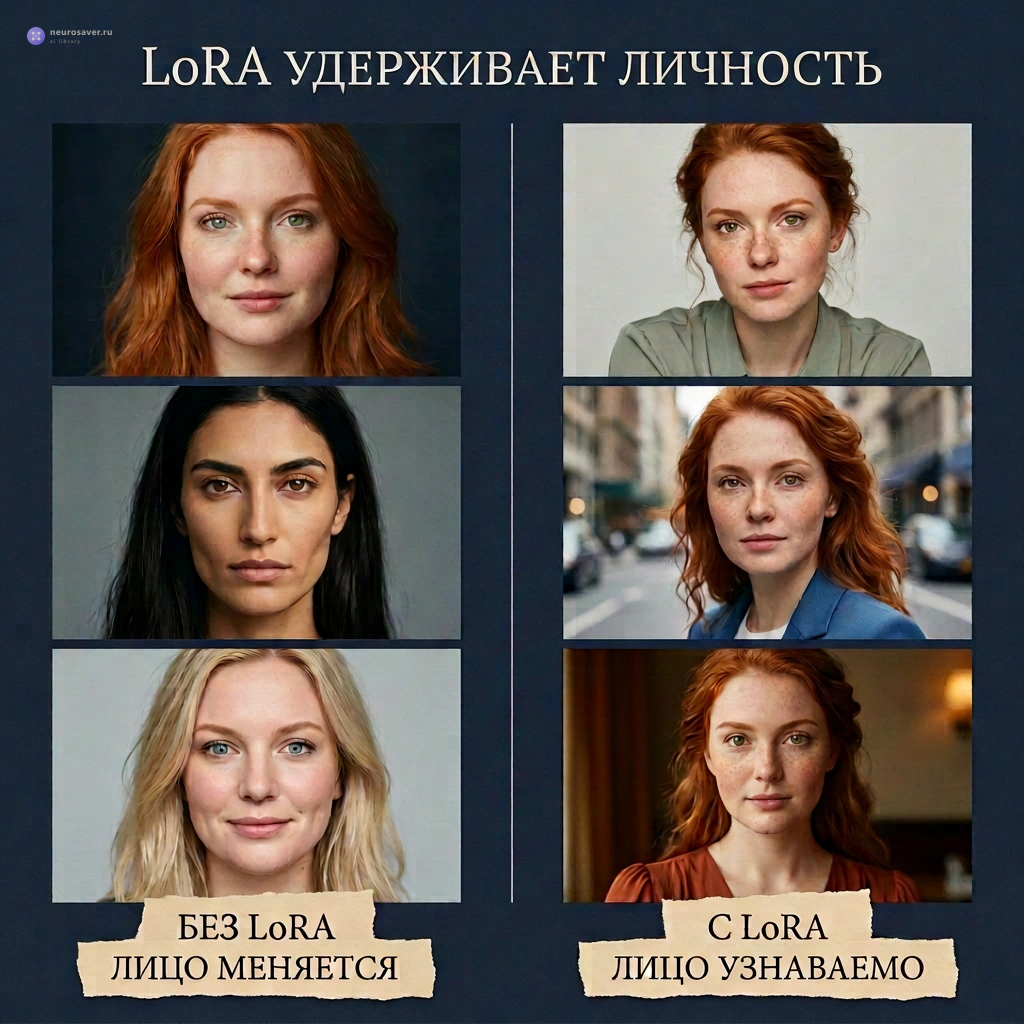
LoRA в ComfyUI: стиль, персонажи, ракурсы и обучение
LoRA помогает настроить стиль, внешность персонажа или отдельную задачу. Разберём подключение в ComfyUI, совместимость с моделью, силу влияния, слова-триггеры и сочетание нескольких…

Контекстное редактирование изображений: как AI меняет картинку по инструкции
Контекстное редактирование меняет изображение по обычной фразе: модель пытается учесть сцену, найти нужный объект и сохранить всё остальное. Разберём, когда достаточно инструкции,…
