
Большой разбор
Что такое LLM и как она работает: от токенов до ответа
Языковая модель умеет продолжать текст, отвечать на вопросы и разбирать код. Посмотрим, как из токенов складывается ответ, чему модель учится заранее и какие сведения получает во время разговора. Это помогает понять и её пользу, и ошибки: убедительное объяснение не всегда подтверждается фактами.
С чего начнём
В этом разборе
Можно читать по порядку или выбрать нужную тему в оглавлении.
- Что такое языковая модель
- Как модель учится и отвечает
- Контекст, ошибки и возможности
Что такое языковая модель
Ответ появляется по кусочкам
Представим обычную задачу: есть расшифровка встречи, а из неё нужен короткий список решений. В окне чата всё выглядит просто — вставили текст, написали просьбу, получили аккуратные пункты.
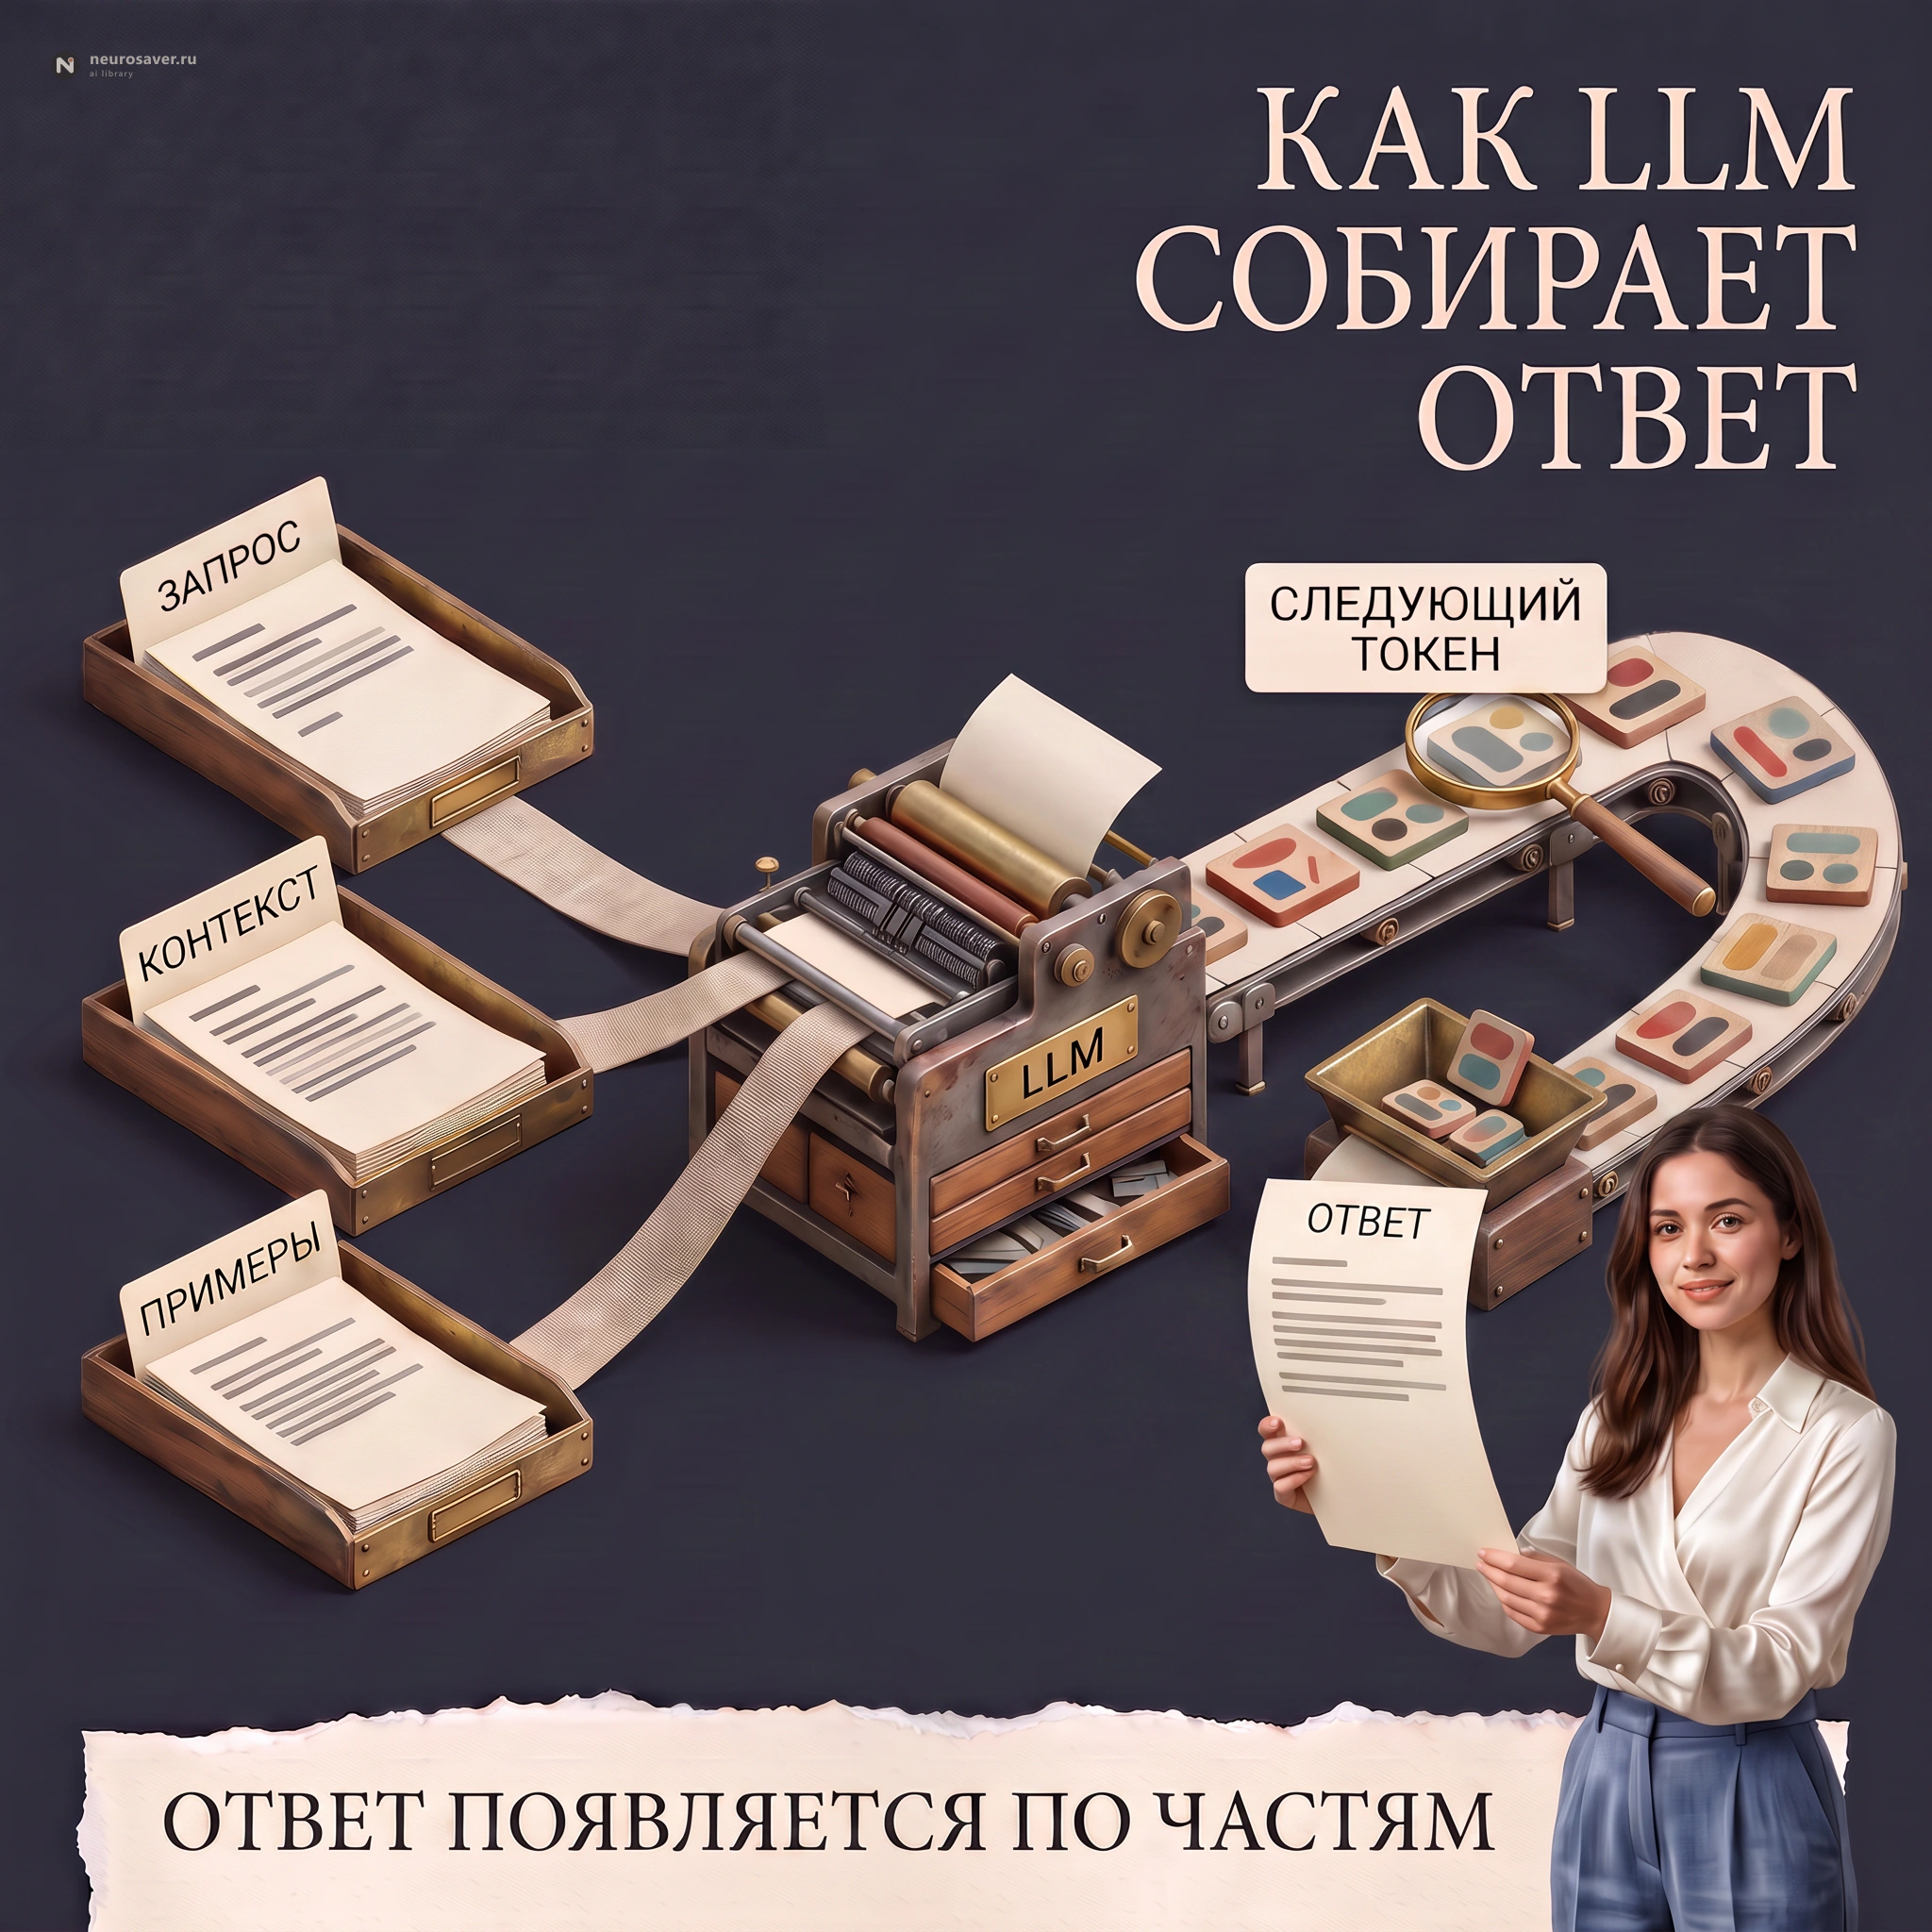
Чтобы составить такой конспект, модели не нужен заранее написанный ответ. Модель получает вашу инструкцию вместе с расшифровкой и начинает продолжать эту последовательность: выбирает следующий небольшой фрагмент текста, затем ещё один и ещё. Каждый выбор зависит от того, что уже находится в доступном контексте.
Так устроена распространённая авторегрессионная LLM — Large Language Model, или большая языковая модель. Её удобно сравнить с автодополнением, но это лишь аналогия. Многослойная сеть обучается сложным зависимостям в данных, поэтому может поддерживать диалог, менять стиль и разбирать код. Есть и другие языковые модели, например диффузионные, которые восстанавливают несколько позиций текста, а не только дописывают его слева направо.
Что означает название LLM
Название описывает масштаб, материал и способ работы.
- Large — большая. Речь не только о числе параметров. Масштаб складывается из архитектуры, обучающих данных, вычислений и последующей настройки. Большее число параметров само по себе не гарантирует лучший результат на конкретной задаче.
- Language — языковая. Основной материал для такой модели — последовательности текста: обычный язык, программный код, формулы и разметка. В мультимодальной системе к ним могут добавляться изображения, звук и видео, но способ их обработки зависит от архитектуры продукта.
- Model — модель. Это математическая система с обученными весами. В разбираемой здесь авторегрессионной схеме она оценивает вероятности возможного продолжения по входному контексту.
Слово «языковая» не означает, что модель умеет только писать статьи. Таблица в текстовом виде, программный код и структура JSON тоже состоят из последовательностей. Поэтому один базовый механизм подходит для перевода, классификации, извлечения полей, редактуры и генерации кода.
ChatGPT, Claude и Gemini — не названия одного файла
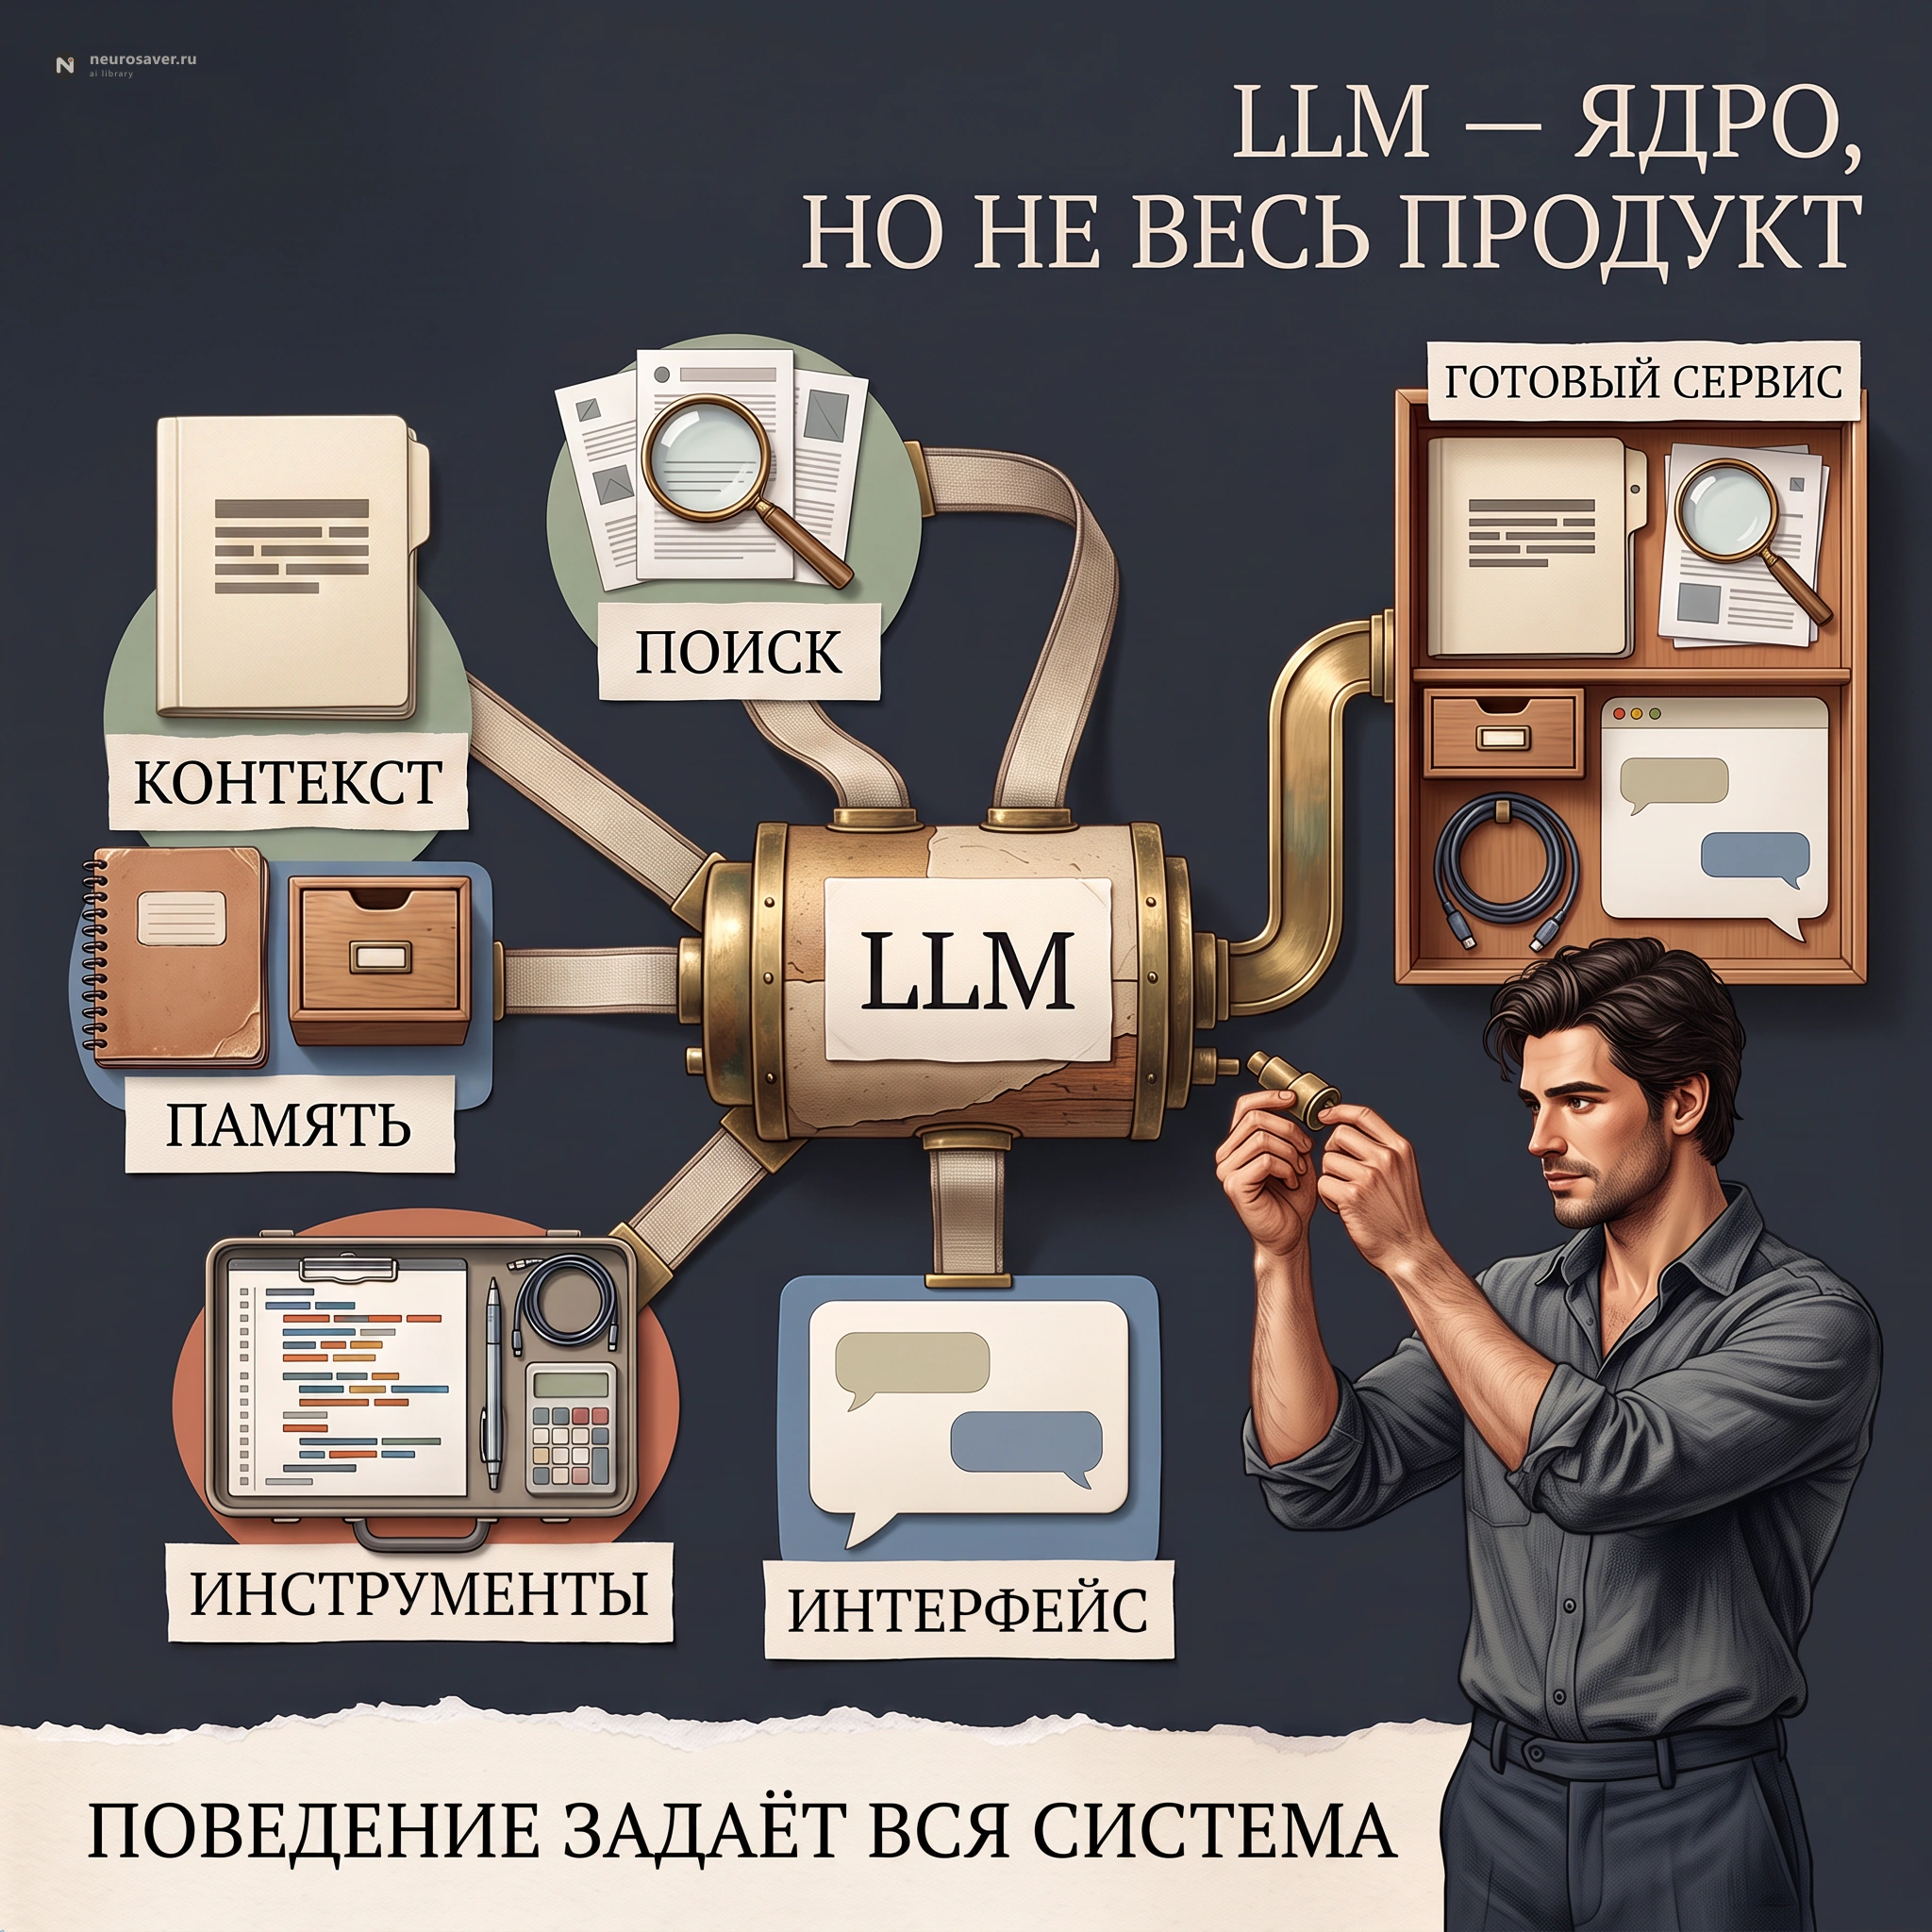
ChatGPT, Claude и Gemini чаще всего встречаются как готовые продукты. Внутри продукта могут меняться модели и режимы, а вокруг них работают дополнительные компоненты:
- системные инструкции;
- поиск и подключённые источники;
- загрузка и разбор файлов;
- выполнение кода;
- память и проекты;
- фильтры безопасности;
- голосовой или графический интерфейс.
Поэтому фраза «эта LLM умеет искать в интернете» обычно неточна. Искать может отдельный инструмент, а модель получает найденные фрагменты и формирует ответ. То же относится к календарю, почте, базе данных и запуску программы.
Такое разделение помогает сравнивать системы честнее. Модель создаёт языковое продолжение, а программа вокруг неё выбирает контекст, ограничивает доступные действия и показывает результат. Сравнение на рабочих задачах разобрано отдельно в статье о ChatGPT, Claude и Gemini.
Как модель учится и отвечает
Как LLM собирает ответ
Разберём авторегрессионную модель на основе трансформера — схему, распространённую среди генеративных LLM. У других архитектур отдельные шаги устроены иначе.
1. Текст превращается в токены
Сначала токенизатор делит вход на элементы своего словаря. Токеном может быть целое короткое слово, часть слова, знак препинания или несколько символов. Граница зависит от конкретного токенизатора: нельзя заранее считать, что одно слово всегда равно одному токену или что русский текст обязательно дороже английского в фиксированное число раз.
Каждому токену соответствует числовой идентификатор. Фраза для человека превращается в последовательность чисел, с которой уже может работать нейросеть.
2. Токены получают числовые представления
Идентификатор переводится в эмбеддинг — вектор чисел. При обработке также учитывается позиция в последовательности. В одних архитектурах позиционное представление добавляется к вектору, в других положение учитывается внутри механизма внимания. Дальше представление меняется на каждом слое: один и тот же токен в разных предложениях получает разный контекстный смысл.
Например, одинаково записанный фрагмент «ключ» может иметь одно исходное представление и в инструкции к замку, и в описании базы данных. После обработки соседних слов его контекстное представление будет разным. Само слово при этом может разбиваться на один или несколько токенов.
3. Attention связывает части контекста
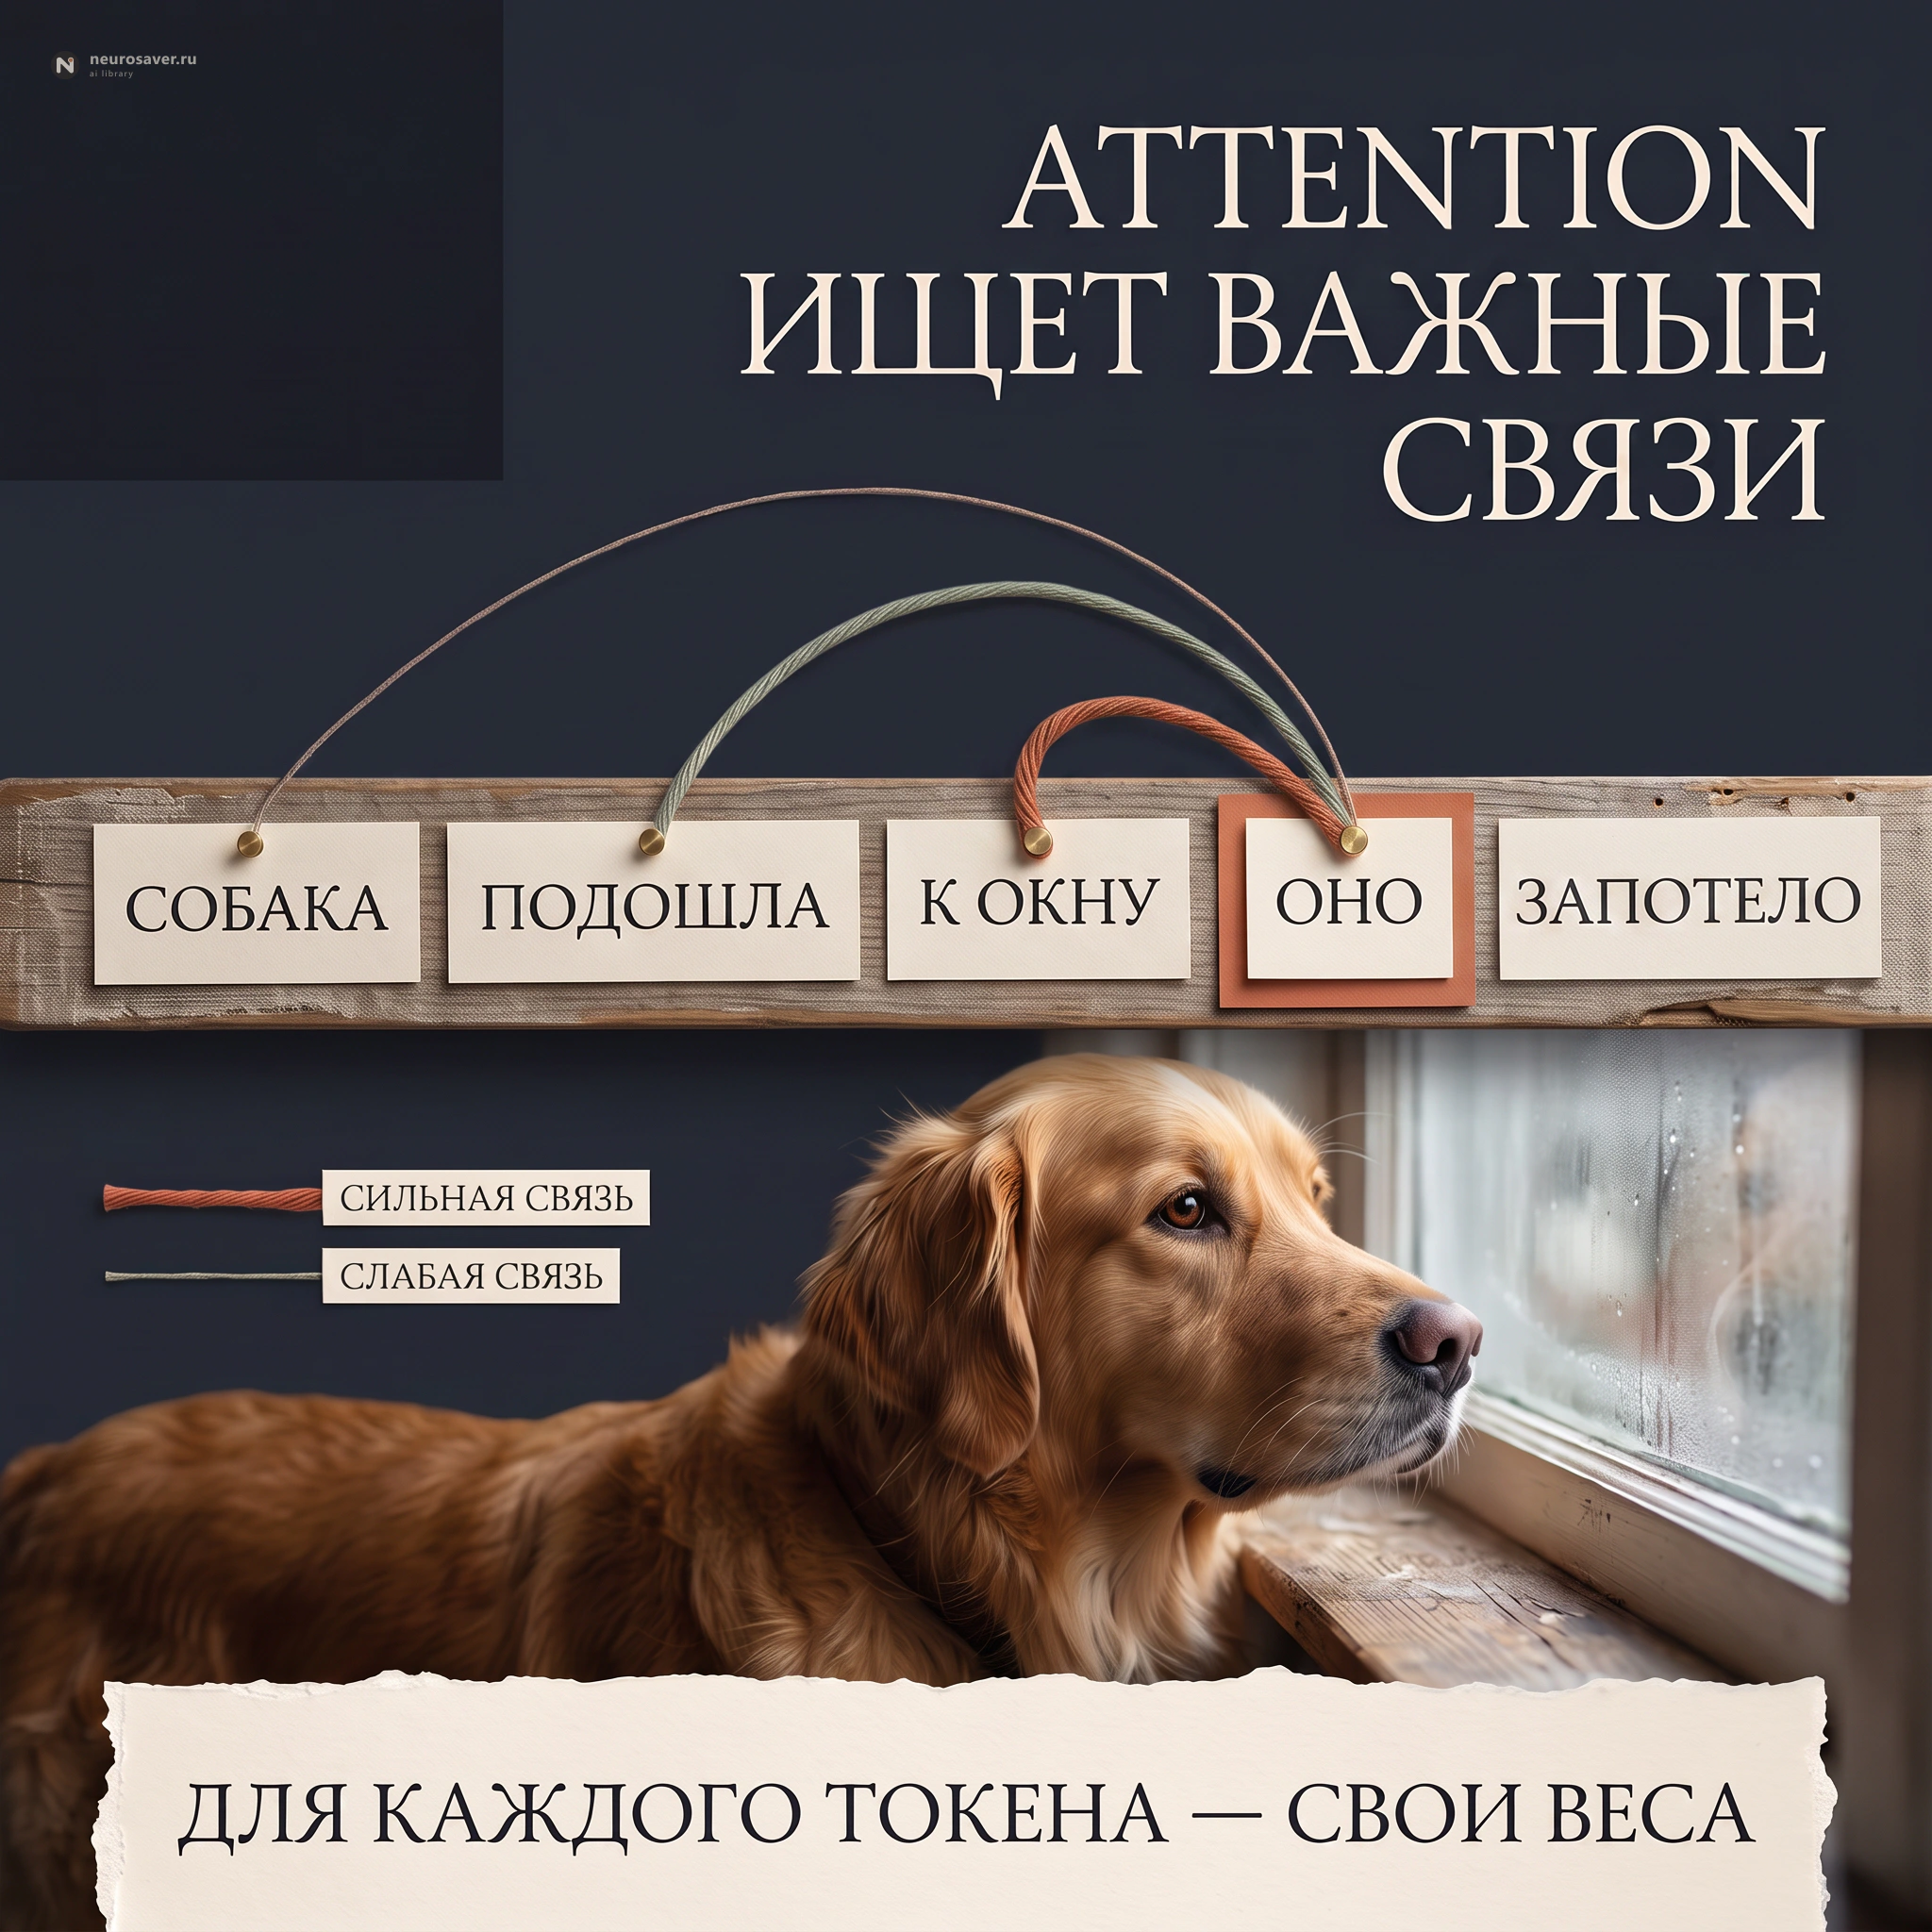
Механизм attention помогает каждой позиции определить, какие предыдущие части последовательности сейчас важнее. В этой авторегрессионной схеме действует причинное ограничение: при выборе следующего токена она опирается на уже доступный контекст, а не заглядывает в ещё не написанное продолжение.
Связи вычисляются многократно и в нескольких представлениях. Разные слои и головы внимания могут учитывать синтаксис, связи между именами и другие зависимости. По одной картинке весов внимания нельзя надёжно восстановить весь ход решения. Это не готовая карта правил: полезные шаблоны возникают в весах во время обучения.
Архитектура Transformer появилась в работе Attention Is All You Need. Современные модели сильно отличаются от первой схемы: меняются типы attention, позиционные представления, маршрутизация параметров и способы экономить память. Базовая идея при этом узнаваема — контекст обрабатывается как система взаимосвязанных элементов.
4. Модель выбирает продолжение
После слоёв нейросети получается распределение вероятностей по словарю. Система выбирает следующий токен, добавляет его к последовательности и повторяет расчёт. Так постепенно появляются предложение, абзац и весь ответ.
Temperature («температура»), top-p и другие параметры влияют на выбор следующего токена. Температура меняет соотношение вероятностей: при более высоких значениях у редких вариантов обычно больше шансов. Top-p ограничивает набор кандидатов по их суммарной вероятности. Не каждая модель позволяет менять эти настройки, а допустимые значения зависят от API. Меньший разброс ответов не гарантирует точности или нужного формата. Универсального числа для «кода» или «творчества» нет.
Откуда у модели появляются навыки
Обучение обычно состоит из нескольких больших фаз, но одинакового рецепта для всех лабораторий нет.
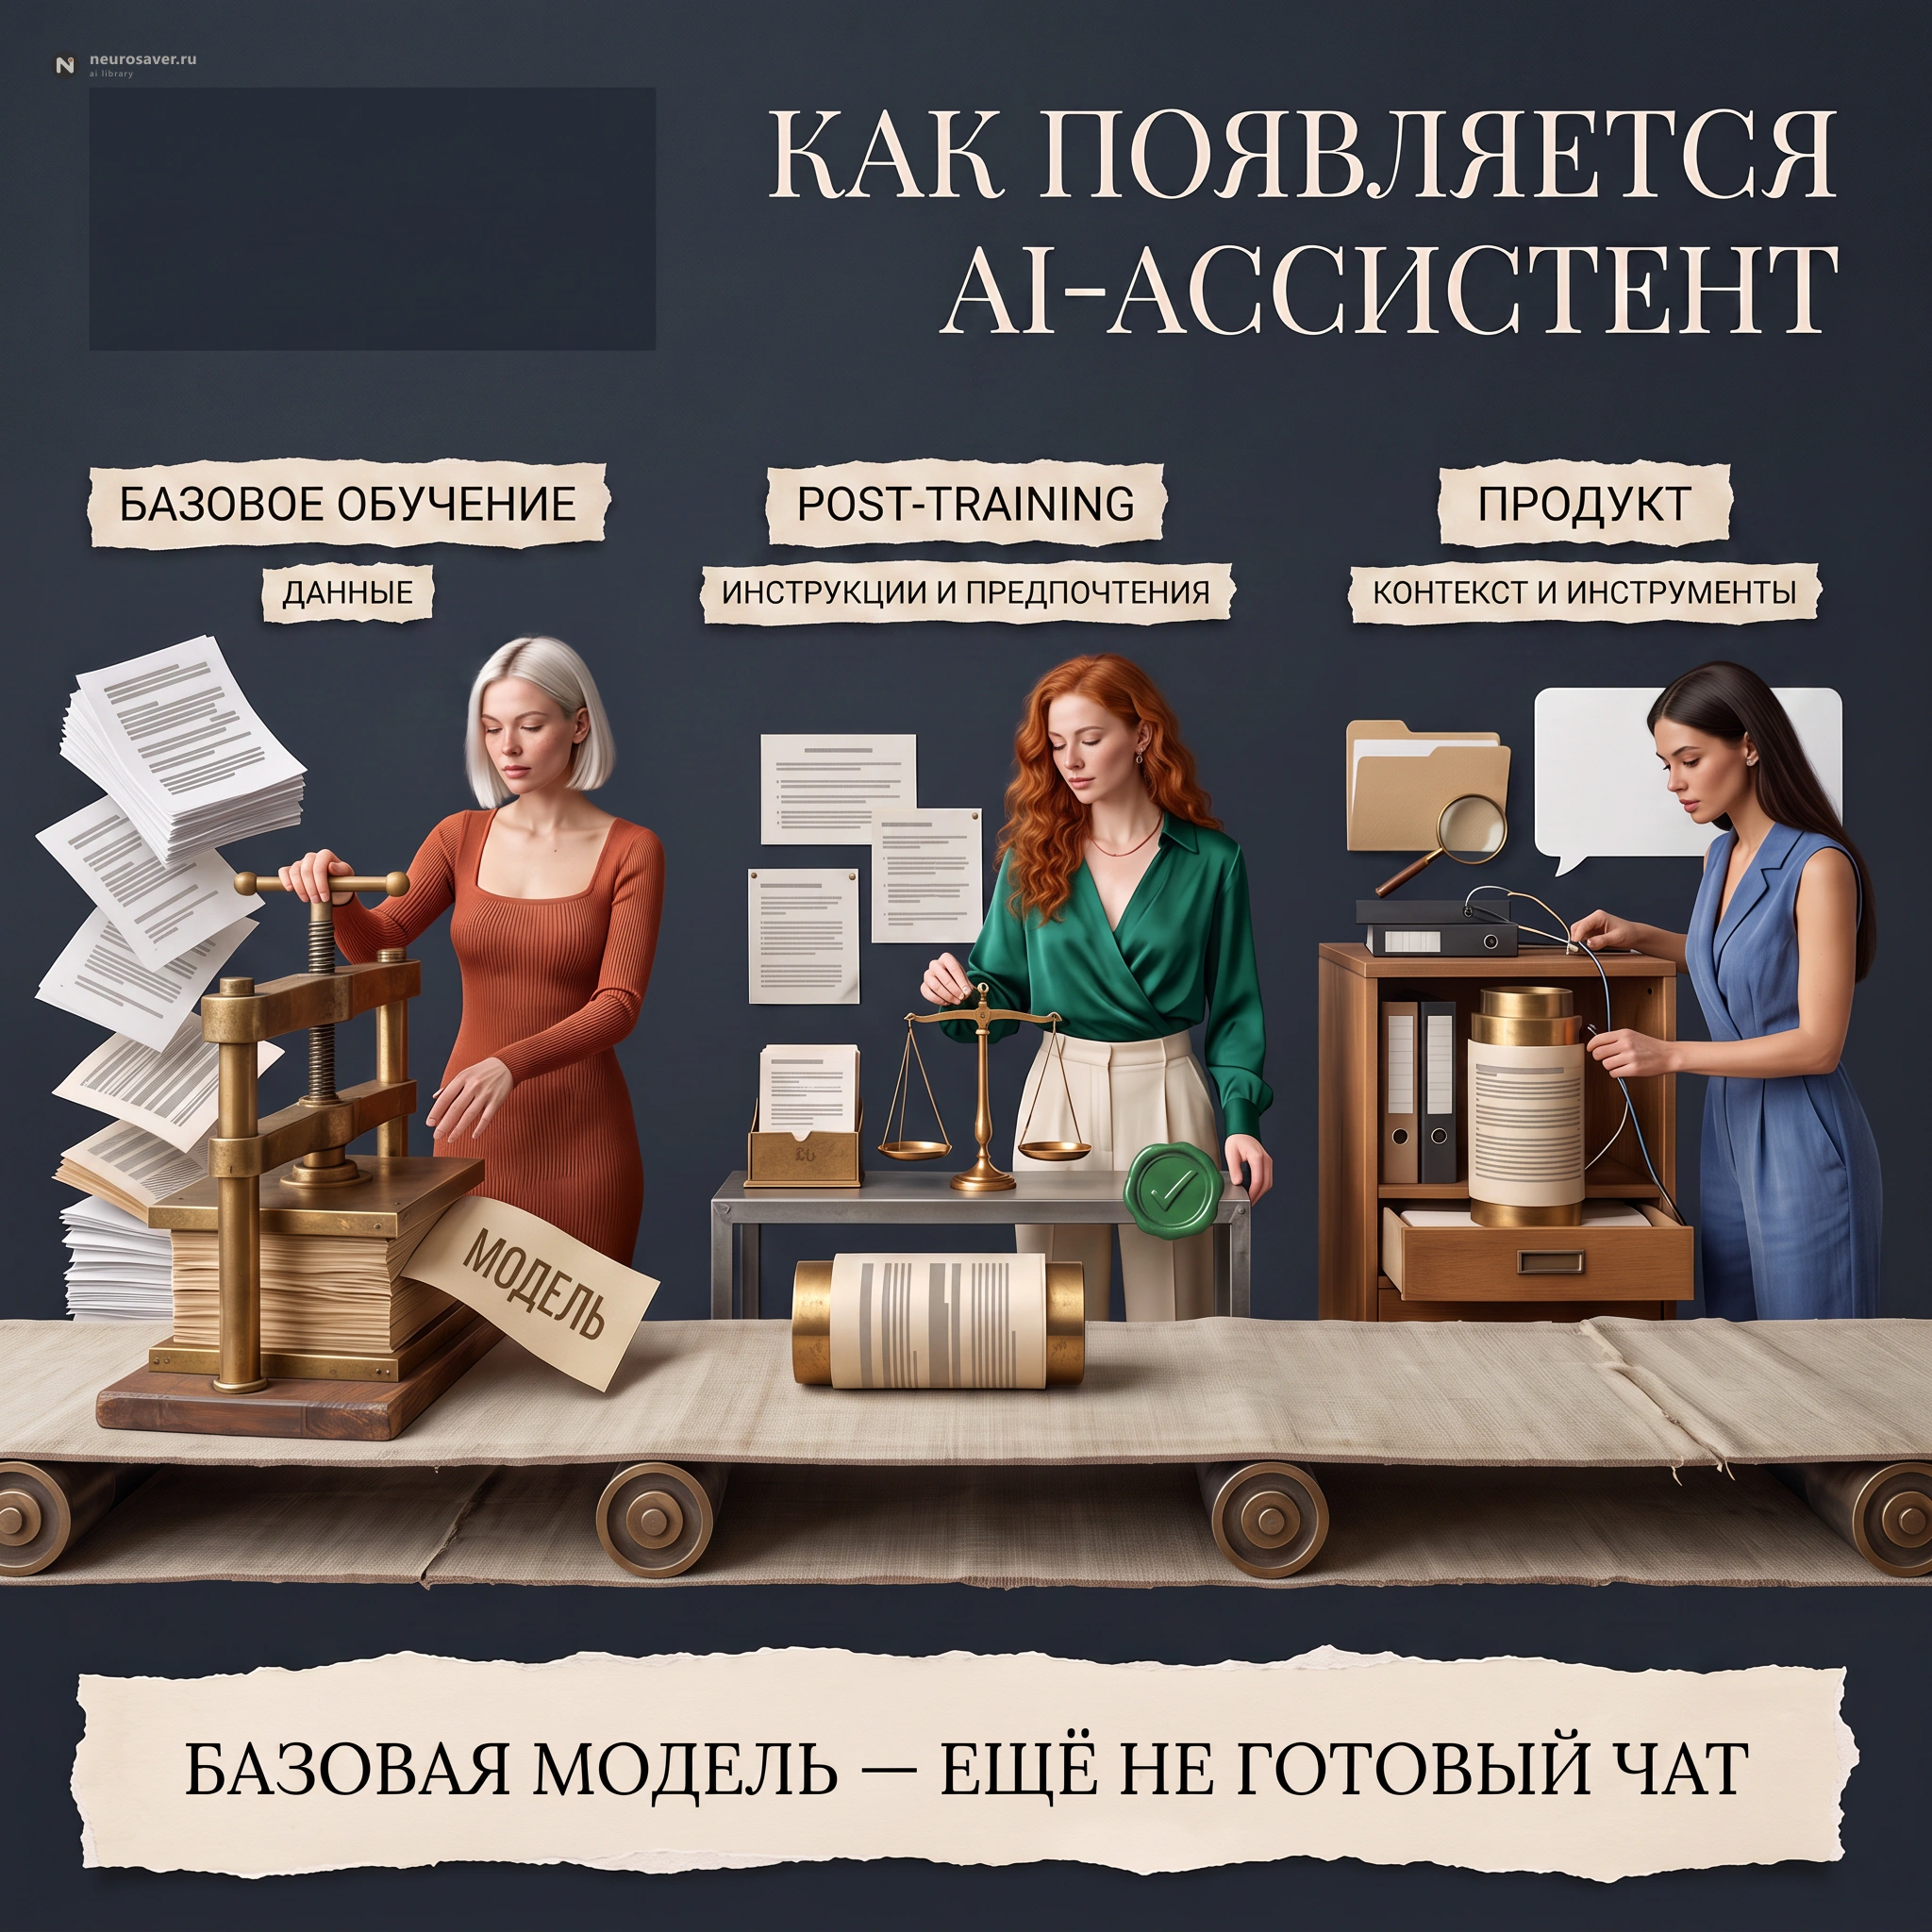
Базовое обучение
Во время pre-training модель видит большие массивы последовательностей и учится предсказывать скрытый или следующий токен. Ошибка возвращается через сеть и понемногу меняет параметры. После множества повторов веса начинают отражать языковые закономерности, фактические связи, стили и шаблоны решения задач, встречавшиеся в данных.
Это не копирование интернета в виде страниц. Веса не устроены как поисковый индекс, хотя крупная модель способна воспроизводить отдельные фрагменты, особенно если они часто повторялись. Состав данных, фильтрация, дедупликация и права на материалы остаются важной частью качества и рисков.
Дополнительная настройка — post-training
Базовое продолжение текста ещё не обязано быть удобным собеседником. Затем модель настраивают следовать инструкциям, соблюдать формат и отказываться от нежелательных действий. Для этого используют демонстрации хороших ответов, данные о предпочтениях, синтетические примеры, обучение с подкреплением и другие методы.
Известная работа InstructGPT показала один из вариантов: обучение на примерах ответов, затем модель оценки предпочтений и обучение с подкреплением по человеческой обратной связи — RLHF. Это важный пример, но не обязательная трёхступенчатая схема для любой современной LLM. Дополнительная настройка может отдельно затрагивать решение многошаговых задач, вызов инструментов, работу с кодом и безопасное поведение.
Проверка и выпуск
Перед выпуском модель прогоняют через наборы задач, проверки безопасности и нагрузочные тесты. После этого продукт всё равно продолжает меняться: разработчики могут заменить модель, обновить системную инструкцию, поиск или обработчик файлов. Поэтому название чата не является точной технической спецификацией.
Параметры — не библиотечные полки
Параметры — числа, которые управляют преобразованиями внутри сети. В них распределённо закрепляются закономерности, найденные при обучении. Нельзя открыть один параметр и прочитать там дату основания города или правило пунктуации.
Отсюда следуют две особенности.
Первая: модель способна связно объяснить тему без доступа к исходной странице, потому что многие связи отражены в весах. Вторая: она может смешать похожие шаблоны и получить убедительную, но неверную деталь. Обычная передача нового факта в запросе не обновляет веса: этот факт остаётся частью контекста конкретного ответа.
Число параметров полезно для оценки требований к памяти у открытой модели, но плохо подходит для рейтинга качества. Архитектура, данные, дополнительная настройка, квантизация, инструменты и конкретная задача могут влиять сильнее.
Контекст, ошибки и возможности
Контекст, память и свежие данные
LLM отвечает не только из весов. Во время запроса она получает контекст: системные правила, историю разговора, текст пользователя, фрагменты файлов и результаты инструментов. В доступное окно должно поместиться то, что передаётся модели для этого ответа; часть бюджета может потребоваться для самого ответа и промежуточной работы. Весь загруженный файл не обязательно передаётся целиком: приложение может выбрать фрагменты или сделать сводку.
Большое окно означает, что система может принять больше токенов. Оно не гарантирует, что нужная строка будет найдена и правильно использована. Исследование Lost in the Middle показало, что положение факта в длинном контексте способно заметно влиять на результат. Вывод относится к исследованным моделям и задачам: он не означает, что текст в середине документа всегда будет использоваться хуже. Вместимость окна и качество работы с текстом проверяют отдельно. Практические способы сохранить решения разобраны в статье о потере деталей длинного разговора.
Память между чатами обычно является внешней функцией продукта. Сервис сохраняет заметку или краткое резюме и добавляет его в будущий контекст. Сама модель во время обычного ответа не переписывает свои веса после каждого разговора. Использование переписок для последующего обучения регулируется отдельными настройками и политикой провайдера.
Для свежих или частных данных применяют дополнительные механизмы:
- веб-поиск приносит страницы из внешнего индекса;
- RAG находит подходящие фрагменты в выбранном корпусе;
- tool calling запрашивает программу, базу данных или сервис;
- выполнение кода считает результат, который неудобно надёжно получать простым продолжением текста.
Эти инструменты снижают часть рисков, но не дают автоматической гарантии истины. Поиск может выбрать слабый источник, RAG — пропустить нужный фрагмент, а модель — неверно пересказать полученные данные.
Почему возникают галлюцинации
Галлюцинацией называют правдоподобный ответ, который не подтверждается данными. Для модели гладкая формулировка и фактическая точность — разные цели. Предсказание следующего токена поощряет связное продолжение, даже когда в контексте не хватает надёжного факта.
Чаще проблема заметна в трёх ситуациях:
- запрос требует свежей информации, которой нет в контексте;
- пользователь просит точную цитату, ссылку, число или название;
- задача неоднозначна, а формат ответа не оставляет места для честного «данных недостаточно».
Больше оснований доверять ответу, который можно проверить: с первичным источником, цитатой из переданного документа, воспроизводимым расчётом или тестом кода. Уверенный тон сам по себе не доказывает точность. Порядок сверки фактов и цитат есть в руководстве по проверке ответа нейросети.
Текст, изображения и действия
Базовая LLM работает с текстовыми токенами. Мультимодальная система добавляет компоненты, которые представляют изображение, звук или видео в форме, доступной модели. У разных продуктов это может быть единая модель, связка энкодеров и декодеров или несколько специализированных моделей.
Похожая оговорка нужна для действий. LLM может написать JSON с именем функции и аргументами, но реальный запрос к погодному сервису или изменение файла выполняет приложение. AI-агент добавляет цикл: получить цель, выбрать действие, увидеть результат, проверить состояние и решить, что делать дальше.
С чем легко перепутать LLM
- LLM и чат. Чат — интерфейс. Та же модель может работать через API, редактор кода или внутренний процесс без диалога.
- LLM и поисковик. Поисковик возвращает документы из индекса, модель генерирует продолжение. В одном продукте они могут работать вместе.
- LLM и база знаний. Веса содержат выученные закономерности, но не заменяют обновляемую базу с точными записями и источниками.
- LLM и агент. Агент использует модель для выбора шагов, а действия выполняют инструменты и управляющая программа.
- LLM и весь AI. Языковые модели — один класс среди систем распознавания, рекомендаций, прогнозирования, генерации изображений и других подходов.
Выбор способа работы и проверка
Открытая модель, API или готовый сервис
Работать с LLM можно по-разному.
Готовый сервис быстрее всего начать использовать: интерфейс, хранение истории и инструменты уже собраны. При этом модель, лимиты и обработка данных зависят от поставщика.
API даёт больше контроля над интерфейсом и процессом. Разработчик сам хранит контекст, вызывает инструменты, проверяет структуру ответа и считает стоимость.
Модель с доступными весами может запускаться локально или на своей инфраструктуре. Здесь появляются вопросы лицензии, квантизации, памяти, скорости и поддержки. Слова «открытые веса» не означают автоматически свободную лицензию, бесплатную эксплуатацию или полную приватность: важны условия модели и весь путь данных.
Размер файла приблизительно зависит от числа параметров и точности хранения. Квантизация уменьшает требования к памяти, но её влияние на качество и скорость зависит от модели, формата и оборудования. Кроме весов в памяти лежат кеш внимания и рабочие буферы. Длина контекста и число одновременных запросов могут заметно увеличить расход, даже если файл модели не менялся.
Как оценить ответ в рабочей задаче
LLM удобно пробовать на преобразовании предоставленного материала: сократить текст, изменить тон, извлечь поля, предложить варианты структуры. Даже здесь возможны пропуски и выдуманные детали. Если нужен неизвестный модели факт или точное многошаговое действие, проверка становится ещё важнее.
Для практической проверки обычно достаточно пяти вопросов:
- Получила ли система нужные исходные данные?
- Можно ли проверить факты по источнику или фрагменту документа?
- Был ли расчёт или код действительно выполнен?
- Сохранились ли ограничения и формат задачи?
- Повторяется ли качество на нескольких примерах?
Если ответ не проходит проверку, сначала стоит выяснить причину: не хватило данных, сломался инструмент или модель неверно использовала найденное. Для этих ошибок нужны разные исправления.
Вопросы и дальнейшее изучение
Частые вопросы
Чем LLM отличается от нейросети вообще?
Нейросеть — общее семейство моделей. LLM — его языковая ветвь, обученная работать с последовательностями текста. Не каждая система распознавания изображений, прогнозирования или рекомендаций является LLM.
Что означает B в названии модели?
Обычно B обозначает миллиарды параметров: например, 7B — около семи миллиардов. Для MoE-моделей отдельно различают общее и активное число параметров. У закрытых моделей размер может не публиковаться.
Можно ли обучить собственную LLM?
Базовое обучение крупной модели требует серьёзных данных, вычислений и команды. Для прикладной задачи чаще используют готовую модель, RAG, настройку запроса или fine-tuning. Что выбрать, зависит от причины ошибки: отсутствие фактов не всегда лечится дообучением.
Что такое reasoning-модель?
Reasoning-модели тратят дополнительные вычисления на промежуточную работу перед финальным ответом. Реализация может включать специальное обучение, внутренние рассуждения, проверку вариантов и инструменты. Это режим или класс системы, а не отдельный от LLM принцип.
Что такое RAG?
Retrieval-Augmented Generation сначала ищет релевантные фрагменты в выбранных источниках, затем передаёт их модели вместе с вопросом. Так можно работать со свежими или внутренними документами и прикладывать проверяемые ссылки. Качество зависит и от поиска, и от генерации.
Есть ли у модели дата знаний?
Для модели может быть объявлена дата отсечения обучающих данных. Это ориентир, а не гарантия знания всего, что случилось раньше. В готовом продукте она также не описывает весь ответ: поиск, RAG и подключённые сервисы могут добавить более свежий контекст. Для актуального факта важнее увидеть источник и дату самого события.
Куда двигаться дальше
Механику удобно разбирать по отдельным деталям: Transformer, токены, эмбеддинги, контекстное окно, параметры и inference. Для прикладной стороны пригодятся prompt, RAG, tool calling и AI-агенты.
Если нужен обзор всей темы нейросетей, рядом есть разбор «Что такое нейросеть» и каталог словаря.
В визуальных проектах LLM может помочь описать сцену или разобрать журнал ошибки, а генерацию изображения выполнит другая модель. Такое разделение пригодится при работе по материалам Timesaver VFX и раздела ComfyUI: текстовый помощник и граф обработки выполняют разные части задачи.
Короткий итог
В авторегрессионной LLM ответ складывается токен за токеном, с опорой на обученные параметры и текущий контекст. Базовое обучение даёт языковые закономерности, дополнительная настройка помогает следовать инструкциям, а продукт добавляет файлы, поиск, память и действия.
Эта схема объясняет и сильные стороны, и ограничения. Модель хорошо преобразует предоставленный материал и умеет собирать новые формулировки. Но её ответ не становится фактом только потому, что звучит гладко. Там, где важна точность, системе нужен проверяемый контекст, подходящий инструмент и понятный способ контроля результата.
Подписка Neurosaver
Получать новые разборы Neurosaver
Если вам интересны наши разборы, будем иногда рассказывать о новых материалах. Без ежедневных писем — читайте, когда удобно.
