Machine Learning
machine learning — обучение моделей на данных
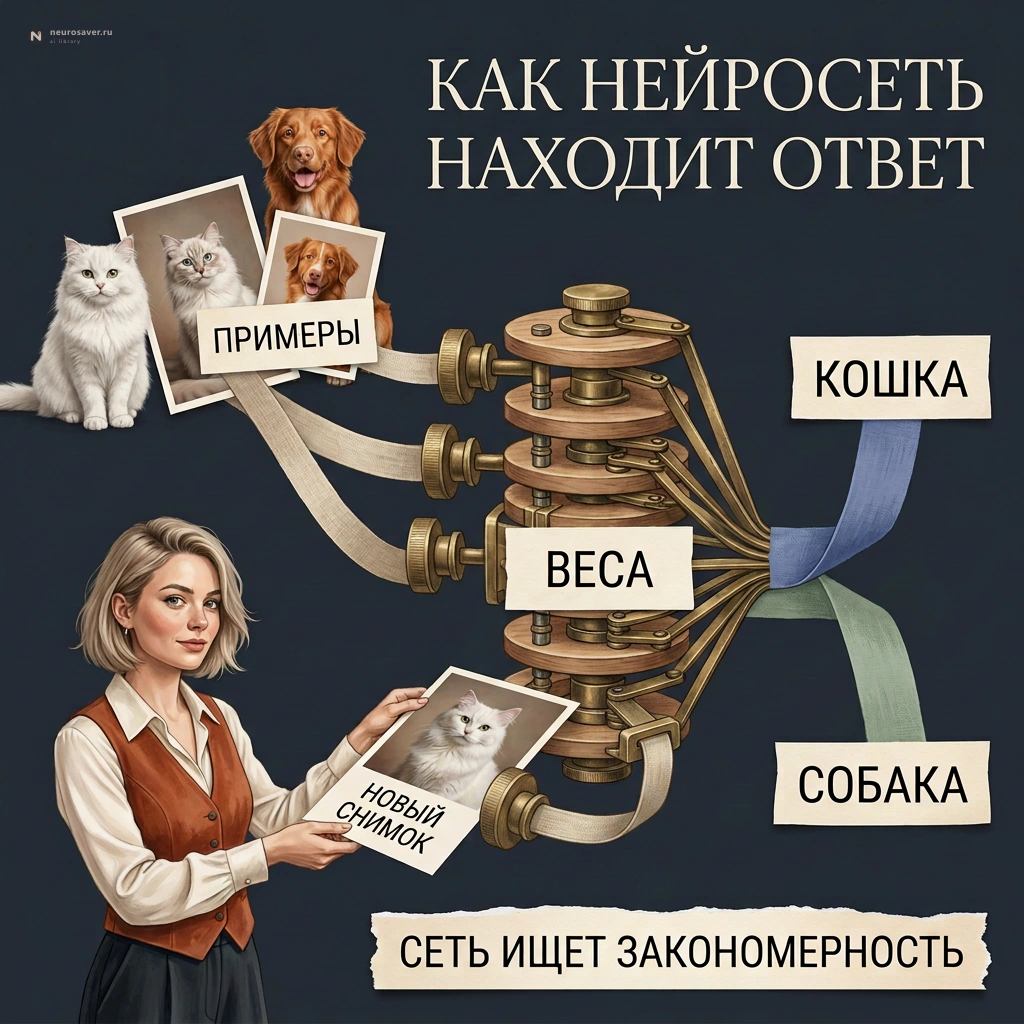
Машинное обучение помогает программе находить закономерности в данных и использовать их для предсказаний, распознавания или генерации. Вместо подробного списка правил для каждого случая разработчик задаёт способ обучения и проверяет результат на отдельных примерах. Данные важны, но сами по себе не гарантируют правильную работу.
Коротко
Machine Learning, или машинное обучение, — подход, при котором модель настраивается по данным или опыту взаимодействия со средой. Затем она применяет найденные закономерности к поданному входу: распознаёт объект, оценивает вероятность, предлагает рекомендацию или создаёт текст.
Программист всё равно задаёт устройство системы, цель и процедуру обучения. Просто не каждое правило принятия решения записывается вручную.
Пример со спамом
Представим почтовый фильтр. Можно составить список запрещённых слов, но слово «выигрыш» встречается и в нежелательной рекламе, и в нормальной переписке.
Другой путь — собрать письма с метками «спам» и «не спам» и обучить модель учитывать сочетания признаков: текст, отправителя, ссылки и другие доступные сведения. Затем проверить её на письмах, которые не участвовали в настройке.
Модель может замечать более сложные сочетания, чем короткий список правил. Но она тоже ошибается. Поэтому в почтовой системе обучение нередко сочетается с обычными правилами, списками доверенных адресов и возможностью вернуть письмо из спама.
Данные, обучение и применение
В обучении с учителем работа обычно выглядит так:
- Подготовка примеров. Для каждого входа есть целевой ответ: категория письма, число на счётчике или стоимость доставки.
- Обучение. Алгоритм подбирает параметры или структуру модели, чтобы лучше решать задачу на обучающих данных.
- Проверка. Отдельные примеры показывают, насколько хорошо модель справляется за пределами обучения.
- Применение. Готовая модель получает вход и вычисляет результат. Это называют инференсом.
- Наблюдение за работой. Ошибки и изменение данных могут показать, что модель нужно обновить.
Не любой метод многократно проходит по данным и не всякое обучение требует нейросети. Линейная модель, дерево решений и глубокая сеть обучаются по-разному. В обычном инференсе параметры не меняются, но есть системы, которые дополнительно обучаются по мере поступления данных.
Какие бывают способы обучения
С учителем — supervised learning. Модель получает примеры с целевыми ответами. Классификация выбирает категорию, регрессия предсказывает число.
Без учителя — unsupervised learning. Готовых меток для нужного ответа нет. Можно, например, сгруппировать похожие обращения. Получившиеся группы ещё предстоит осмысленно назвать и проверить.
Самоконтролируемое обучение — self-supervised learning. Целевые ответы получают из самих данных: например, скрывают фрагмент текста и учат модель восстанавливать его. Человеку не нужно вручную подписывать каждый такой пример. Это не означает, что программа сама выбирает себе цель и способ обучения.
С подкреплением — reinforcement learning. Обучаемая система выбирает действия и получает сигнал награды. Важен не только ближайший результат, но и последствия последовательности действий.
Эти подходы могут сочетаться. Генеративный AI — не обязательно отдельный пятый способ обучения: это описание того, что модель делает на выходе.
Как понять, что модель научилась полезному
Высокая точность на обучающих примерах ещё мало говорит о новых случаях. Модель может запомнить частные особенности или воспользоваться случайной подсказкой.
Допустим, на всех учебных фотографиях собаки сняты на улице, а кошки — дома. Классификатору может оказаться проще различать фон, чем животных. На новом снимке домашней собаки ошибка станет заметна.
Поэтому проверочную выборку подбирают под будущую работу. Она не должна незаметно повторять обучение. Например, соседние кадры одного видео, случайно разнесённые по двум выборкам, могут создать слишком лёгкий тест. Для оценки на новых роликах разумнее разделять данные целыми роликами.
Также важно не использовать при обучении сведения, которые станут известны только после события. Предсказание отмены заказа по полю «дата отмены» будет прекрасным на бумаге и бесполезным до отмены. Это утечка данных.
Пример: разметить видео по содержанию
Допустим, монтажёру нужно найти в архиве уличные сцены и крупные планы лиц. Это две разные характеристики: лицо может быть снято крупно на улице. Поэтому их лучше не заставлять конкурировать как взаимоисключающие классы.
Можно взять готовую модель, которая сопоставляет изображения с текстовыми описаниями, и получить черновые метки для кадров. Обучение под эти конкретные категории не обязательно: это пример применения уже выученных представлений.
Дальше монтажёр проверяет часть результатов, отдельно смотрит трудные случаи и решает, достаточно ли качества для поиска. Если нужны точные границы сцен, одной оценки отдельных кадров мало — потребуется учитывать время и соседние кадры.
Так использование готовой модели отличается от обучения собственной: закономерности уже выучены, а новая работа начинается с проверки применимости. Этот этап подробнее объясняет статья об инференсе.
В генерации изображений то же различие видно в ComfyUI: загрузка checkpoint и запуск графа обычно применяют готовые веса, а не обучают модель заново. С устройством графа знакомит раздел ComfyUI на TimeSaver VFX. Если нужны новые признаки персонажа, подготовка данных — уже отдельная задача, разобранная в статье о фотографиях для обучения.
Почему данных бывает недостаточно
Больше примеров часто помогает, но не автоматически. Значение имеют:
- связь данных с будущей задачей;
- разнообразие условий;
- ошибки в разметке;
- редкие, но важные случаи;
- повторяющиеся записи;
- доступность нужных признаков;
- способ обучения и проверки.
Если модель плохо различает два класса из-за ошибочных меток, добавление таких же ошибок не обязательно улучшит результат. Если важного сигнала вообще нет во входе, увеличение модели тоже может не помочь.
Кривая качества при добавлении данных помогает понять, есть ли польза от расширения выборки. Универсального минимума «тысяча для таблицы, миллион для нейросети» нет.
Когда обычные правила удобнее
Если задача полностью описывается понятным условием — проверить обязательное поле или вычислить сумму по известной формуле — обычный код часто проще и надёжнее.
Машинное обучение полезно там, где закономерности сложны для ручного описания, а данных и способа проверки достаточно. В одном продукте эти подходы спокойно соседствуют: модель распознаёт реквизиты, код проверяет формат и сумму, человек подтверждает спорный случай.
С чем часто путают
AI и ML. Искусственный интеллект шире машинного обучения. К нему относятся и подходы с явно заданными знаниями, поиском решений и правилами.
ML и Deep Learning. Глубокое обучение — часть ML, использующая многослойные нейросети. Деревья решений и линейные модели тоже относятся к ML.
Обучение и инференс. Первое настраивает модель, второе применяет её. Ни длительность, ни обязательность видеокарты не определяют разницу.
ML и статистика. Области тесно связаны и используют общие методы. Статистика занимается не только объяснением, а ML — не только предсказанием без объяснений.
Частые заблуждения
«На новых данных модель обязательно ответит правильно». Хорошая проверка позволяет оценить вероятность ошибок в похожих условиях, а не отменить их. Другая камера, новый язык или изменившиеся привычки пользователей могут повлиять на результат. Почему особенно важны границы применения, показывает статья об AI в здравоохранении.
«ML устанавливает причину по совпадению». Обычный предсказательный алгоритм находит зависимости. Для причинного вывода нужны дополнительные предположения, данные или эксперименты. Причинное моделирование существует, но не появляется автоматически после обучения классификатора.
«Любая ошибка спрятана в весах». Причина может быть в коде, подготовке входа, порядке столбцов, разметке, пороге решения или изменении данных. Такие системы тоже отлаживают, просто проверяют больше компонентов.
«LoRA гарантирует отсутствие забывания». Адаптерное обучение ограничивает набор изменяемых параметров, но не гарантирует сохранение прежнего качества при подключённом адаптере. После дообучения проверяют и старые, и новые задачи.
Частые вопросы
Нужно ли программировать?
Для простого эксперимента иногда достаточно готового интерфейса. Но он не заменяет понимание данных и проверку результата. Встраивание в рабочий процесс добавляет задачи доступа, обработки ошибок и наблюдения за качеством.
Обязательна ли видеокарта?
Нет. Многие табличные модели можно обучать и применять на CPU. Требования нейросетей зависят от размера, данных и выбранного метода; отдельные крупные модели требуют нескольких ускорителей.
Можно ли использовать готовую модель?
Да. Это распространённый вариант: сначала проверяют её на своей задаче, а дообучение рассматривают, если качество не подходит и есть данные для улучшения.
Почему качество со временем падает?
Могли измениться входные данные, связь признаков с ответом или сам способ использования. Иногда причиной становится обновление программы или ошибка обработки. Новое обучение имеет смысл после выяснения причины, а не вместо диагностики.
Главное
Машинное обучение позволяет находить закономерности по примерам, но работает внутри обычной программы с заданной целью и ограничениями. Полезность модели определяется тем, как она справляется с будущими случаями и как обрабатываются её ошибки. Обучение, независимая проверка и наблюдение за реальной работой здесь одинаково важны.