
Большой разбор
MiniMax H3: история, First/Last Frame и видеоредактирование по референсам
MiniMax H3 — семейство аудиовизуальных моделей, в котором текст, фотографии, видео и звук задают общий контекст будущей сцены. FL2VA строит ролик по тексту и граничным кадрам, Ref2VA переносит выбранные свойства референсов и редактирует исходное видео. Разбираем историю H3, оба режима, промпты, локальный запуск и границу между открытыми весами и облачной системой.
С чего начнём
В этом разборе
Можно читать по порядку или выбрать нужную тему в оглавлении.
- Знакомство с H3
- First/Last Frame: начало и конец сцены
- Reference: работа с исходниками
Знакомство с H3
Снять заново, сохранив то, что получилось
В коротком дубле актриса удачно повернулась к окну. Движение камеры тоже получилось, но нужна другая одежда, а реплику придётся заменить. В обычном генераторе каждое исправление рискует уничтожить удачные части: новое лицо, другая комната, потерянный жест. Автор снова просит «примерно то же самое» и получает ещё одну версию сцены.
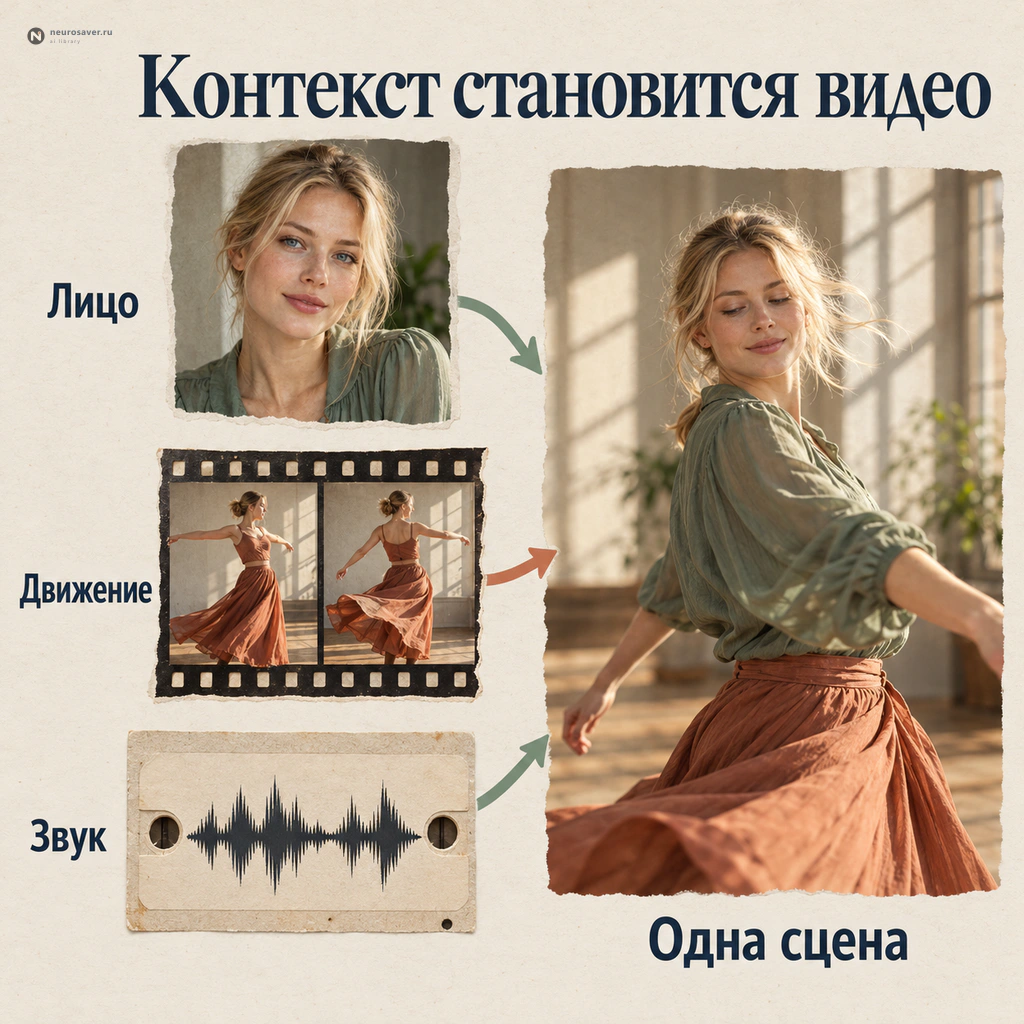
В MiniMax H3 можно загрузить исходное видео, портрет, фотографию одежды и звук, а затем указать, что взять из каждого материала. Например, портрет задаёт внешность, видео — движение, аудиозапись — голос. Так можно изменить выбранную часть сцены, используя уже найденные образы и удачно снятое действие.
Факты и совместимость проверены на 22 октября 2026 года. Это исследовательский разбор, не отчёт о нашем запуске H3. Собственные AI-иллюстрации ниже объясняют принципы; настоящие результаты модели показаны отдельными официальными роликами. Указанные возможности не означают, что любой дубль получится с первой попытки.
Маршруты по статье
Оглавление содержит все разделы. Для быстрого выбора задачи:
- Нужна история и устройство: от Hailuo к H3, общий контекст, открытая и облачная части.
- Есть начальный и финальный кадры: FL2VA, практический двуязычный промпт.
- Есть исходный ролик, лицо, движение или голос: Ref2VA, карта источников, полный пример редактирования.
- Нужна установка: ComfyUI, Python и сервер, память и ускорения.
- Нужно использовать результат в работе: контроль качества, лицензия, разница с LTX и VACE.
От Hailuo к H3: как менялась задача
H3 создала MiniMax, компания, основанная в начале 2022 года. Над базовой моделью работала команда; это отличается от истории Pony Diffusion, которую один автор дообучал на основе готовой модели. MiniMax также разрабатывает языковые и речевые модели, но общее имя компании не означает, что все её продукты устроены одинаково. О компании.
Ранние публичные демонстрации видеогенерации Hailuo относятся к концу августа 2024 года. На следующем этапе разработчики отдельно развивали постановку движения и камеры. В феврале 2025-го в истории моделей появились Director-версии T2V-01 и I2V-01; в июне вышла Hailuo 02, позднее — Hailuo 2.3. История моделей, анонс Hailuo 02.
Если смотреть на эту последовательность как на историю интерфейса, поворот хорошо заметен. Сначала автор описывает, что должно появиться. Затем — как это снять. В H3 появляется ещё один вопрос: что взять из уже существующего материала. Так генератор приближается к работе постановщика и монтажёра, которым редко нужен совершенно случайный новый дубль.
| Этап | Подтверждённое событие | Что изменилось в логике работы |
|---|---|---|
| Конец августа 2024 года | Ранние публичные видеодемонстрации MiniMax | Из текста получается движущаяся сцена |
| 11 февраля 2025 года | Director-версии T2V-01 и I2V-01 | Движение камеры становится отдельной управляемой частью задания |
| 18 июня 2025 года | Анонс Hailuo 02 | Продолжается развитие видеогенерации и следования сложной сцене |
| 28 октября 2025 года | Hailuo 2.3 и Fast | Разработчики уделяют особое внимание движениям и выражениям лиц |
| 31 июля 2026 года | Представлена H3 | Общий контекст объединяет изображение, видео, аудио и текст |
| 3 августа 2026 года | Объявлено открытие H3-Base | Доступны веса двух вариантов, а не только облачный интерфейс |
Даты сверены по анонсу Hailuo 2.3, первому материалу H3 и сообщению об открытом релизе. Дата в файле лицензии — 2 августа; это не повод переносить на неё дату публичного сообщения.
Подробности обучения раскрыты не полностью. В проверенных официальных материалах нет отчёта с полным составом обучающих данных, бюджетом и инструкцией, по которой можно повторить обучение. Поэтому нельзя достоверно назвать стоимость создания H3 или описать весь набор использованных роликов. Опубликованные веса и описание архитектуры отвечают лишь на часть этих вопросов.
Что означает «контекстная видеомодель»
Контекст в H3 — материал, который помогает определить будущую сцену. Фотография может задавать лицо; короткий ролик — характер поворота или траекторию камеры; звук — тембр, реплику либо часть дорожки. Текст связывает эти источники: не просто перечисляет вложения, а объясняет, какой признак откуда перенести и что оставить неизменным.
Допустим, нужно заменить персонажа, сохранив удачно снятые движения актёра. Портрет задаёт внешность, видео — паузы и движения, аудио — голос и манеру речи. Если не объяснить эти роли, материалы могут противоречить друг другу: на одной фотографии человек в пальто, на другой — в рубашке; в одном ролике он смотрит вправо, в другом — влево. По фразе «сохрани всё» нельзя понять, какой вариант нужен.
Из этого следуют три разных операции. Генерация по референсам создаёт новую сцену с выбранными признаками. Редактирование видео берёт существующий ролик за основу изменения. Продолжение развивает происходящее после его конца. Одни и те же файлы могут участвовать во всех трёх задачах, но отношение к ним будет разным. Эти типы прямо разделены в официальном руководстве Full-Reference.
Референс при этом не равен обучению. Для каждого нового портрета не требуется создавать отдельную LoRA. Контекст предъявляется во время генерации. Это удобно для разового дубля, но не гарантирует устойчивость целого сериала: сложный поворот, перекрытое лицо или новый свет всё ещё могут изменить персонажа.
Два варианта H3-Base: что выбирать
Названия First/Last Frame и Reference соответствуют двум официальным вариантам: H3-Base-FL2VA и H3-Base-Ref2VA. Окончание VA означает, что результат включает видео и аудио. Варианты различаются тем, какие исходные материалы направляют генерацию; это не два последовательных поколения модели.
| Задача | FL2VA: First/Last Frame | Ref2VA: Reference |
|---|---|---|
| Видео только по тексту | Основной сценарий без картинок | Не причина выбирать Reference |
| Начало, конец или оба граничных кадра | Прямой сценарий | Возможно в совместимых workflow с дополнительными временными якорями |
| Персонаж или предмет из набора фотографий | Картинка прежде всего привязана к границе ролика | Изображение может задавать отдельное свойство будущей сцены |
| Движение и постановка из другого видео | Не обычный вход этого режима | Видео служит источником движения, структуры или редактирования |
| Голос или исходный звук | Звук создаётся по заданию | Можно задать отношение к аудиореференсу |
| Что описать особенно точно | Путь между состояниями | Роль каждого источника и границы изменения |
В опубликованной спецификации Reference указаны до девяти изображений, до трёх видео и до трёх аудиофайлов, но всего не более двенадцати файлов. Для видео и аудио каждый фрагмент — 2–15 секунд, суммарно в каждой категории — до 15 секунд. Складывать максимумы в «9 + 3 + 3 одновременно» нельзя. В отдельных клиентах есть дополнительные ограничения. Официальная карточка вариантов и входов.
First/Last Frame: начало и конец сцены
First/Last Frame: задать начало, конец и разумный путь
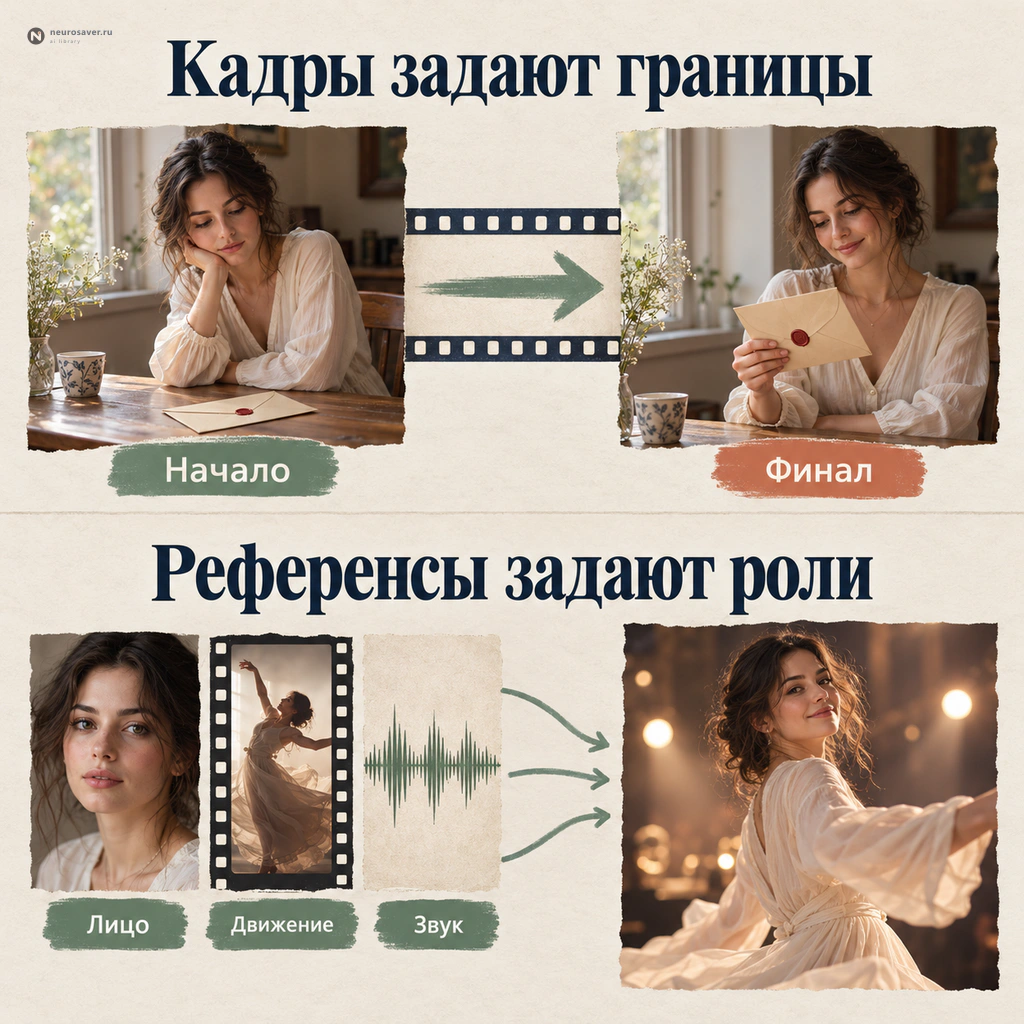
В FL2VA картинка привязана к конкретному месту во времени. Без изображений получается текстовая генерация. Один кадр может задавать начало или финал; два — обе границы. Разница существенна: начальный кадр говорит «отсюда начинается действие», последний — «к этому состоянию нужно прийти».
На столе лежит закрытое письмо. В финале героиня держит его в руке. Между этими двумя фотографиями модель должна построить движение: заметить письмо, протянуть руку, взять конверт, поднять. Если дополнительно попросить три смены помещения, объятие и взрыв конфетти за короткий дубль, граничные кадры не спасут перегруженную постановку.
Самая полезная единица задания здесь — наблюдаемое изменение. Не «девушка переживает важный момент», а «она замечает конверт, поднимает его и ненадолго замирает». Эмоцию лучше привязать к видимому действию: паузе, взгляду, напряжению пальцев. Тогда описание помогает построить промежуток, вместо того чтобы спорить с изображениями.
Два кадра не превращают генерацию в гарантированную физическую интерполяцию. Если на первом человек держит чашку правой рукой, а на последнем чашка неожиданно в левой, модель может придумать перекладывание — или скрыть ошибку морфингом. Перед запуском полезнее согласовать сами границы, чем пытаться исправить противоречие десятком запретов.
Настоящий официальный пример: один первый кадр
В FL2VA-примере разработчиков сначала видна еда, затем камера показывает семью. В запросе закреплён только кадр с индексом 0. Поэтому ролик демонстрирует генерацию по первому кадру, но не показывает, насколько точно модель воспроизводит заданный финальный кадр. Исходный запрос и результат опубликованы вместе, чтобы пример можно было повторить. Запрос FL2VA.
Промпт FL2VA: русская постановка и английская рабочая версия
У официального Base-формата сначала идёт соответствие кадров времени, затем три поля: описание происходящего, звуковая среда и музыка за кадром. Времена должны соответствовать реальной длительности задания. Для одного непрерывного плана начало и финал принадлежат одному Shot; при монтаже финальный якорь относится к последнему плану. Формат Base.
Ниже — наш учебный сценарий, а не выполненный тест H3. Условная длительность — 8 секунд. Первая картинка показывает закрытый конверт на столе, вторая — ту же взрослую героиню с тем же конвертом в руке. Обе подготовлены в одной геометрии и с одной одеждой.
Русская версия постановки:
Один непрерывный реалистичный план. В начале героиня сидит у окна, закрытый конверт лежит перед ней. Она замечает его, правой рукой берёт со стола и спокойно поднимает до уровня груди. Камера чуть приближается; к концу поза, конверт и композиция соответствуют второму кадру. Дневной свет и одежда не меняются. Слышны тихая комната и шорох бумаги. Речи и музыки нет.
Рабочая английская версия:
How the reference pictures align with the target video — Picture 1 (from Shot 1) aligns with the 0.00-second mark of the target video; Picture 2 (from Shot 1) aligns with the 8.00-second mark of the target video.

integrated_multimodal_description: [Shot 1] Live-action, one continuous medium shot. An adult woman sits at a wooden table beside a softly lit window. Begin in the composition of <Picture 1>, with a sealed envelope on the table. She notices the envelope, reaches for it with her right hand, lifts it smoothly and pauses with it at chest height. The camera makes a slow, small push-in. By the end, reach the pose, hand placement, envelope position and framing of <Picture 2>. Keep her identity, blouse, room and daylight consistent throughout. No dialogue and no cuts.

overall_soundscape: Quiet indoor room tone and a soft paper rustle synchronized with the envelope being lifted.

non_diegetic_music: N/A.
В официальном руководстве по подготовке запроса для H3 основной текст требуется писать на английском. Русский черновик удобен, чтобы продумать сцену, а английскую версию можно отправить модели в нужном формате. Это правило конкретного руководства, а не всех видеомоделей. Русскую реплику персонажа переводить не нужно: текст внутри <d>[Russian] …</d> остаётся на своём языке.
Перед отправкой полезно проверить, достаточно ли конкретно описана сцена. Вместо «медленно движется камера» можно задать короткое приближение без смены ракурса, а вместо «сохрани атмосферу» — постоянный дневной свет и отсутствие музыки. Так проще проверить, выполнила ли модель задание; одного слова «cinematic» для этого недостаточно.
Reference: работа с исходниками
Reference: что взять из каждого исходника
Ref2VA подходит, если нужно взять внешность, предметы, движение или звук из разных материалов. Для каждого загруженного файла нужно объяснить, что именно использовать: сам по себе портрет или ролик ещё не задаёт эту роль.
По портрету актрисы в синем жакете модель может воспроизвести и лицо, и одежду. Если с фотографии нужна только внешность, укажите это, а нужную одежду покажите отдельно. Иначе в результат может попасть синий жакет, который вы не собирались использовать. С видео та же сложность: в нём одновременно видны игра актёра, освещение, комната, смена планов и движение камеры.
Один источник может играть несколько ролей, но каждую нужно назвать. Например, из исходного дубля берутся темп и движения рук, из портрета — черты лица, из отдельной фотографии — новая блузка. Если лицо намеренно заменяется, не нужно просить сохранить его из старого видео; жесты при этом можно оставить прежними.
В этом и состоит удобство контекстного монтажа. Автор работает с уже найденным материалом, а не каждый раз описывает всё заново. Плата за удобство — необходимость точнее сформулировать границы задачи. Чем больше источников, тем полезнее короткая карта их назначения.
Карта источников: лицо, пластика, одежда, камера и звук
Для учебного редактирования возьмём пять секунд исходного видео и два изображения. Первая фотография задаёт внешность новой героини, вторая — одежду. Видео передаёт движения, руки и камеру. Его звук намеренно не используется. Отдельная аудиозапись служит только образцом тембра.
| Материал | Что берём | Что не переносим автоматически | Как проверить |
|---|---|---|---|
| Портрет, Picture 1 | Черты лица, причёску, узнаваемую внешность | Фон портрета, его одежду и неподвижную позу | Крупный план, профиль и момент поворота |
| Фото одежды, Picture 2 | Цвет, материал и крой блузки | Человека и фон фотографии | Одежда такая уже в первом кадре, не появляется морфингом |
| Исходное Video 1 | Жест, положение рук, темп и движение камеры | Старое лицо и старый костюм | Совпадает структура действия, не только финальная поза |
| Отдельное Audio 1 | Тембр и манеру речи | Сам текст записи и её музыку | Произнесена новая реплика, голос не скачет между словами |
Эта таблица снимает два типичных конфликта. «Сохрани видео полностью» противоречит смене внешности. «Используй аудио» не объясняет, копировать дорожку или только её голосовой характер. Указание роли полезнее общего усилителя вроде «максимально точно».
В официальном формате Subject обозначает человека, предмет, одежду или действие, за которыми модель должна следить. Метки Picture и Video указывают на исходный файл или опорный кадр. Во всех полях запроса одна метка должна означать одно и то же. Если портрет нужен только для задания внешности персонажа, его достаточно указать в описании Subject: дополнительно назначать его опорным кадром не требуется. Определения Full-Reference.
Перенос движения и камеры: что именно повторять
У движения есть несколько масштабов. Поворот головы — актёрское действие. Проезд камеры — постановка съёмки. Смена крупности через монтаж — структура ролика. Просьба «возьми движение отсюда» может относиться к любому из них. Хороший промпт называет нужный масштаб и допускаемые изменения.
В рекламном дубле можно сохранить момент, когда рука поднимает флакон, но заменить сам флакон и поверхность стола. В танцевальном видео — повторить последовательность движений, не требуя точного совпадения положения пальцев. Для новой сцены можно взять только плавный объезд камеры, а действие героя придумать заново. Это разные задачи, даже если используется один исходный ролик.
Пример ограничения: исходная камера обходит человека сзади, а портрет показывает только лицо анфас. Модель должна достроить то, чего в референсе не видно. Пропажа серьги, изменение затылка или формы воротника в такой ситуации не обязательно означает ошибку подключения. Контекст просто не содержит нужных деталей. Дополнительный согласованный ракурс иногда полезнее длинного описания «точно тот же человек».
Официальный пример общего контекста
В материале MiniMax показана сцена, собранная из разных источников: визуальный образ, движение камеры и вокал заданы раздельно. Ролик ниже относится к демонстрации системы H3. Его нельзя без дополнительного подтверждения называть результатом исключительно локального H3-Base без облачных стадий. Официальная демонстрация.
Смена одежды, предметов и окружения
В контекстном редактировании слово «замени» должно описывать готовый дубль, если не нужен эффект превращения. «У неё теперь зелёная блузка с первого кадра» и «её рубашка постепенно становится зелёной» — разные сцены. Это особенно заметно на коротких видео: случайный морфинг способен занять почти весь ролик.
В предметной рекламе отдельно проверяют форму, движение и надпись. Модель может убедительно воспроизвести флакон, но исказить мелкую этикетку. Если текст должен быть точным, надёжнее добавить его при последующей обработке и проверить каждый кадр, где он виден. Общего сходства с товаром для этого недостаточно.
С фоном действует тот же принцип. «Заменить комнату на оранжерею, сохранить человека и жест» не обещает неизменность каждого пикселя волос. Свет нового пространства должен взаимодействовать с героем; иногда полное сохранение освещения старого дубля делает результат менее правдоподобным. Поэтому полезно заранее решить, что важнее: исходная фотографическая фактура или согласованный свет новой сцены.
Клинап — удаление лишнего — тоже может быть текстовой задачей Reference. Однако «убери сумку» и редактирование под точной маской дают разную степень контроля. Там, где сохранность соседней области критична, нужны дополнительные инструменты, о которых ниже, либо обычный монтажный/композитинговый этап.
Звук: скопировать дорожку, взять тембр или создать новую речь
В H3 звук — часть постановки, но у аудиореференса нет единственного значения. Иногда требуется сохранить запись целиком. Иногда — взять голос и произнести новый текст. Иногда — сохранить музыку, добавив другую речь. Эти отношения не стоит прятать в одну фразу «используй Audio 1».
Если запись копируется вместе со всеми звуками, в формате есть fully_copy. При добавлении новой речи или эффектов логичнее указать частичное использование, а не одновременно требовать неизменный полный трек. Для тембра применяется отношение reference: это ориентир голоса, а не команда воспроизвести весь файл.
В учебном случае с двумя людьми нужно отдельно назвать говорящего и молчащего слушателя. Номер Subject не равен номеру голоса. Первый реально звучащий персонаж получает S1, даже если в списке людей он второй. Слушателю без реплик не нужен собственный номер говорящего. Иначе артикуляция способна перейти на крупное лицо в кадре, которому речь вообще не предназначалась.
В ComfyUI дорожка видео становится аудиоконтекстом только при соответствующем подключении. Сам факт, что MP4 содержит звук, недостаточен. Номера Audio выдаются отдельно от Video, поэтому Audio 2 может быть дорожкой Video 1. Это проверяется по нативным узлам MiniMax H3, а не угадывается по имени файла.
Русская речь заявлена среди поддерживаемых языков. На практике её всё равно нужно слушать: окончания, ударения, темп и соответствие губ. Наличие языка в спецификации не означает безошибочную актёрскую речь, а короткая реплика обычно проще для проверки, чем плотный монолог на всю сцену.
Полный Reference-промпт: меняем образ и реплику, сохраняем действие
Сначала постановка по-русски. Это редакционный пример для подготовки своего запуска; редакция его не генерировала. Все персонажи вымышленные и взрослые, голосовой образ предполагается использовать с разрешения владельца.
Отредактировать пятисекундный исходный дубль. Внешность героини взять с первого портрета, блузку — со второй картинки. С первого кадра она уже выглядит так; превращения в кадре нет. Сохранить её жест с конвертом, руки, движение камеры, комнату и дневной свет исходного видео. Она одна произносит: «Кажется, это письмо для меня». Отдельная запись задаёт тембр, а не текст. Исходный звук видео не подключён. Создать тихий фон комнаты и шорох бумаги, без музыки.
Рабочая версия использует шесть полей Full-Reference. Метки файлов ниже соответствуют конкретному набору: две картинки, одно видео без подключённой дорожки и одно отдельное аудио. При изменении входов нумерацию нужно проверить заново.
subject_definitions:
<Subject 1> is the adult woman (S1), with identity and hairstyle from <Picture 1>, wearing the sage silk blouse shown in <Picture 2>. Her acting and hand movement come from <Video 1>.
<Video 1> is the five-second source video to edit. It supplies the room, daylight, envelope action, camera movement and timing. Its soundtrack is not used.
<Audio 1> is the authorized voice-timbre and delivery reference for <Subject 1> (S1), not a track to copy.

summary:
[video editing + reference generation + audio reference] The target video is an edited version of <Video 1>. Replace the woman's identity using <Picture 1> and her blouse using <Picture 2> from the opening frame onward. Preserve the source action and camera timing. She speaks the new Russian line using the vocal character of <Audio 1>.

retention_analysis:
<Subject 1>: fully_preserved. Keep the identity, hairstyle and blouse established by the pictures throughout Shot 1.
<Video 1>: partially_preserved. Retain the room, daylight, framing, camera path, envelope gesture and action timing, adapting lip movement to the new line. Replace the original woman's appearance and clothing; do not reproduce its soundtrack.
<Audio 1>: reference. Transfer voice timbre and measured delivery only. Do not copy its words or background sounds.

detailed_description:
Live-action with natural daylight and restrained, realistic color.
[Shot 1] One continuous five-second medium shot in the room of <Video 1>. <Subject 1> already has the face and hairstyle of <Picture 1> and the blouse of <Picture 2> at the beginning. There is no on-screen transformation. Follow the original envelope gesture and camera movement. As she raises the envelope, <Subject 1> (S1) says softly: <d>[Russian] Кажется, это письмо для меня.</d> Her visible lip movements belong to this line only. Keep the envelope physically consistent in her hand. No cuts, no extra people and no added objects.

overall_soundscape:
Generate quiet indoor ambience and a restrained paper rustle synchronized with her hand. Her new voice is clear and close. Do not use the source video's audio.

non_diegetic_music:
N/A.
Здесь нет слова «идеально». Зато можно проверить каждую просьбу: новая внешность уже в начале, правильная блузка, тот же жест, одна реплика, нет старого трека. Это гораздо полезнее для повторного запуска: если не удалась одежда, исправляется её роль, а не весь промпт целиком.
Формат retention_analysis не превращает вероятностную модель в систему слоёв с гарантированным сохранением. Слова fully_preserved и attribute_transfer описывают желаемое отношение к источнику. Они не являются проверкой идентичности пикселей. Для монтажного материала всё равно нужны визуальная приёмка и прослушивание.
Настоящий официальный пример Reference
В воспроизводимом Ref2VA-примере разработчики редактируют сцену с мужчиной в розовом костюме и ягнёнком, используя исходное видео и аудиореференс. Показательный момент — сочетание изменения реплики и голосового ориентира с сохранением структуры сцены. Это результат MiniMax, не наш тест; точные входы и промпт доступны в официальном запросе Ref2VA.
Продолжение, раскадровка и несколько планов
Продолжить видео — значит начать новое действие из состояния, которым заканчивается исходник. Если в последнем кадре рука уже держит конверт, новая сцена не должна снова брать его со стола. В промпте полезно отдельно описать точку стыка: позу, направление взгляда, текущую фазу движения и звуковой фон.
Раскадровка задаёт другую связь. Набор изображений может описывать порядок планов и композицию, а не внешность персонажа. Тогда это нужно назвать прямо. Иначе модель способна воспринять несколько кадров как альтернативные образы одной сцены, а не последовательность монтажа.
Несколько планов помогают сменить ракурс, но усложняют контроль лица, одежды и звука. Для проверки идеи разумно сначала получить один понятный дубль. Если проблема именно в монтажной последовательности, наращивание количества референсов лица её не решит: нужно описать, что нового показывает следующий план и где происходит смена.
В видео с речью особенно полезно различать звук в кадре и голос за кадром. Если героиня смотрит в окно, а слышен её внутренний комментарий, движение губ не требуется. Это часть постановки, а не мелкое уточнение на последней строке.
Устройство модели и локальный запуск
Что открыто: H3-Base и две закрытые стадии
Система H3 в официальном описании состоит из трёх частей. Context-IR разбирает общий контекст и формирует структурированное представление задания. H3-Base создаёт базовый аудиовизуальный результат. Regenerate-2K пересобирает его в более высоком разрешении с обращением к исходному контексту.
Открытый релиз охватывает два варианта H3-Base. Context-IR и Regenerate-2K в него не входят. Это объясняет, почему локальный запуск и облачная демонстрация могут отличаться не только железом. У них бывает разная подготовка запроса и разная финальная стадия. Состав открытого релиза.
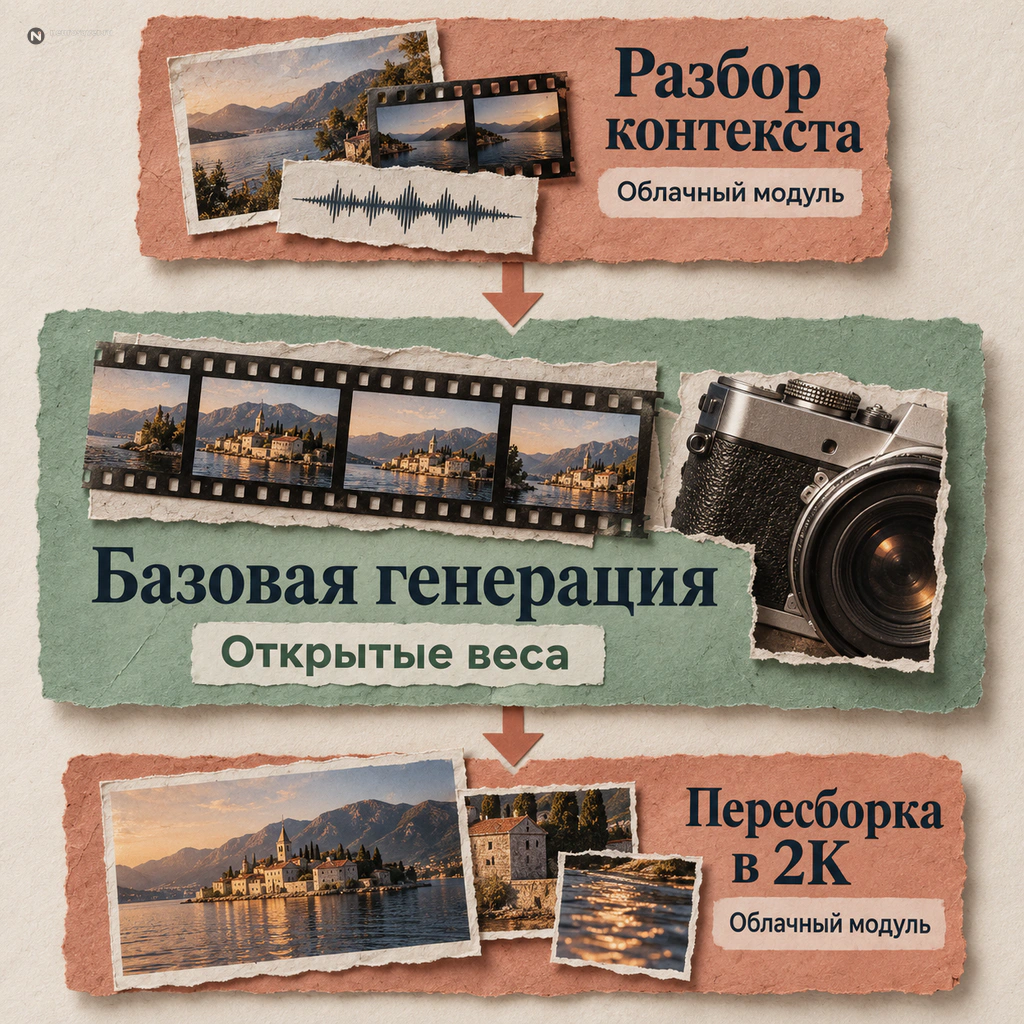
Regenerate-2K не следует описывать как обычное увеличение картинки. Это отдельный генеративный проход с использованием контекста. Сторонний локальный апскейлер может быть полезен, но его результат не становится тем самым официальным Regenerate-2K. Для воспроизводимости в статье или портфолио нужно называть реальную цепочку.
Практический ориентир открытой базовой генерации — короткая сторона около 768 пикселей. Заявленные для полной системы 2K не означают, что скачивание обоих вариантов H3-Base автоматически даёт все возможности облачной системы. Аналогично наличие API у бренда не гарантирует, что старый запрос для Hailuo 02 подходит H3.
Как H3 соединяет изображение, время и звук
В основе H3-Base — плотный 33-миллиардный OmniTransformer с общей последовательностью разных модальностей. Это не MoE, где для каждого токена включается лишь часть экспертов. Внутри общей структуры оказываются визуальная и аудиальная информация, а механизм внимания связывает их с заданием.
Выходы модуляции AdaLN можно заранее вычислить и кэшировать; поэтому около 13 миллиардов связанных параметров не требуется загружать при развёртывании только для генерации. Отсюда встречаются облегчённые pruned-файлы. Но цифра «около 20 миллиардов после pruning» не описывает размер всего рабочего процесса: энкодер и VAE никуда не исчезают. Архитектурное описание H3-Base.
Визуальный VAE сжимает пространственно-временные данные, аудио имеет своё латентное представление. Модель работает не с каждой исходной точкой изображения как с независимым объектом, а с компактными признаками. Это роднит её с другими латентными генераторами, но не делает их VAE взаимозаменяемыми. Степень сжатия и формат каналов должны соответствовать конкретной модели. Конфигурация video VAE, компоненты audio VAE.
Энкодер построен на Qwen3-VL-32B, однако нужен именно вариант и обработка признаков для H3. Обычный файл с похожим именем не гарантирует правильную работу: важны выбранные признаки, специальные токены и совместимый токенизатор. Конфигурация текстового энкодера, процессор модели.
Совместная генерация создаёт возможность согласовывать действие и звук на одном временном отрезке. Но возможность не равна гарантии. Стук может прозвучать чуть раньше касания, а речь — не совпасть с губами. Поэтому проверка синхронизации остаётся отдельным этапом, даже если модель умеет выдавать оба потока сразу.
Локальный путь через ComfyUI
Для знакомства с локальным запуском удобны встроенные шаблоны ComfyUI: T2V, I2V и R2V. Они принимают разные исходные материалы и требуют разных весов генератора. Переписать текст в I2V-графе недостаточно, чтобы он превратился в Reference: необходимо выбрать соответствующий вариант модели и узлы контекста. Встроенные шаблоны H3.
Порядок работы с официальными шаблонами:
- Обновить совместимую сборку ComfyUI и открыть официальный шаблон нужной задачи. Для текста и граничных кадров — FL2VA, для набора референсов — R2V/Ref2VA.
- Проверить модель генерации, H3-совместимый энкодер, видео-VAE и аудио-VAE. Разложить файлы по каталогам, указанным именно в выбранном шаблоне.
- Подготовить короткие согласованные источники. Сначала один человек, один жест и минимум лишних материалов.
- Подключить изображения, видео и звук в фактическом порядке узлов. После этого написать карту Picture/Video/Audio и только затем финальный промпт.
- Сохранить схему и запустить короткий черновик. Проверить персонажа, движение и звук до увеличения разрешения или усложнения сцены.
Для начала доступны JSON T2V, JSON I2V и JSON R2V. Эти файлы обновляются; список моделей и соединения нужно сверять с загруженной версией, а не со старым скриншотом.
Если соединения узлов пока непонятны, пригодится разбор ComfyUI с нуля. Установку и частые ошибки также разбираем в материале о ComfyUI на TimeSaver VFX. После генерации ролик нужно смонтировать, проверить звук и согласовать цвет; этим задачам посвящены отдельные материалы TimeSaver VFX.
Номера аудио: незаметная причина чужого голоса
В нативном Reference-узле изображения и видео нумеруются внутри своих категорий. Звук имеет собственную очередь: подключённые дорожки видео, затем отдельные аудиовходы. Если у двух видео включён звук, самостоятельный ref_audio_1 может оказаться Audio 3 в промпте. Цифра в имени сокета не обязана быть итоговой текстовой меткой.
Перед запуском запишите соответствие меток файлам: «Audio 1 — дорожка первого видео; Audio 2 — дорожка второго; Audio 3 — образец тембра». Если исходный звук не нужен, лучше не подключать его, чем пытаться исключить длинным запретом в промпте. Точный порядок виден в исходнике нативных узлов.
Частота кадров источника
Кадры Reference в соответствующем нативном workflow интерпретируются на шкале 24 fps. Последовательность из исходника 30 fps нельзя просто назвать «24 fps»: изменится темп. Нужен корректный пересчёт либо загрузчик, который сохраняет временные сведения. Иначе плохой результат будет выглядеть как слабое понимание движения, хотя ошибка возникла ещё до модели. Документация H3 в ComfyUI.
Можно ли совместить Reference и точные кадры
Да, в совместимых реализациях Reference не ограничивается мягкими подсказками. Нативный workflow Multiframe использует Add Guide for MiniMax H3, чтобы добавить временные якоря. Например, лицо задаётся портретом, движение — видео, а начальная и конечная композиции — отдельными изображениями. Multiframe Reference.
Здесь легко спутать два канала. Изображение, добавленное только как временной guide, задаёт кадровое условие, но не становится автоматически Picture N в текстовом контексте. Если промпт ссылается на него как на отдельную картинку, нужно проверить и соответствующий reference-вход. Пустая текстовая ссылка не создаёт отсутствующее подключение.
Временные индексы также требуют внимания: на шкале 24 fps кадр 48 находится примерно через две секунды. Отрицательный индекс в данном узле считается от конца. Это удобный механизм, но он не отменяет согласования поз, длины ролика и реальной кадровой сетки.
Выбор между двумя вариантами поэтому не сводится к правилу «FL умеет границы, Ref никогда не умеет». FL — прямой и более простой путь для граничных кадров; Reference нужен для ролей источников и может дополняться кадрами там, где это поддерживает конкретный клиент.
Маски и ControlNet: где заканчивается базовая Reference-задача
Для пространственно управляемых правок есть отдельный MiniMax-H3-Fun-Controlnet-Union от Alibaba PAI. Он использует управляющие признаки вроде глубины, контуров или позы и поддерживает сценарии inpainting с маской. Это дополнительный инструмент, не третий оригинальный checkpoint MiniMax. Карточка Alibaba PAI.
В ComfyUI ему нужен свой patch и соответствующий узел применения; некоторые сценарии дополнительно требуют извлечения позы или другой карты управления. Подготовка маски, видео и координат становится частью качества. Руководство Fun ControlNet.
Практическое различие простое. При свободном Reference-редактировании автор говорит «убери лампу». При масочном — ещё и задаёт область, где разрешено вмешательство. Это полезно, когда соседняя рука, край одежды или надпись не должны меняться. Но и маска не превращает генеративный результат в гарантированный clean plate: границу, отражения и движение всё равно нужно проверять.
Python и сервер: как выбрать подходящий пример запуска
В Diffusers H3 использует ModularPipeline. Выбранная схема запуска определяет загружаемый вариант: ref2va обращается к Reference-части, t2va и fl2va — к базовому трансформеру. Если не указать нужный вариант, могут загрузиться лишние крупные компоненты. Автоматически сгенерированный пример «Use model» с обычным DiffusionPipeline и обращением к images[0] не следует принимать за проверенный рецепт видеогенерации H3. Документация Diffusers.
Загрузчик референса тоже имеет значение. Объект MiniMaxH3VideoReference.from_file() сохраняет сведения о частоте и дорожке; последовательность картинок без временной информации — уже другой вход. Если интерфейс возвращает видео со звуком, экспорт должен сохранять оба потока, а не только кадры.
Для серверного запуска опубликованы SGLang cookbook и рецепт vLLM-Omni. Здесь важно различать корневой model ID, вариант весов и тип задачи. «Video-to-video» может быть применением Ref2VA, а не буквальным допустимым значением параметра API.
Длительность следует проверять по результату. Разные реализации используют свою сетку кадров и валидацию; например, диапазон, принимаемый Diffusers, не во всём совпадает с продуктовой карточкой. Округление способно дать ролик немного длиннее запрошенного. Для монтажа под существующую реплику нужна фактическая длина, а не только число секунд в форме.
Сколько памяти нужно и что действительно ускоряет H3
Базовая модель H3 и её энкодер занимают много памяти. Кроме весов, при запуске нужно разместить VAE и промежуточные результаты вычислений; расход памяти также зависит от длины ролика, разрешения и набора референсов. Поэтому заявления «хватит 12 GB» недостаточно: нужно знать точность весов, объём оперативной памяти и какие компоненты выгружаются из видеопамяти во время работы.
В материалах ComfyUI перечислены полные BF16-веса порядка 66 GB и pruned-варианты порядка 40 GB; квантизованные файлы могут быть заметно меньше. Эти цифры — размеры конкретных файлов, не обещание запуска на видеокарте такой ёмкости. Файлы и требования H3.
Здесь нужно различать три способа облегчения модели. Квантование уменьшает точность хранения весов или вычислений. При pruning в данном случае определённые части модели удаляют либо заранее вычисляют, чтобы не загружать при генерации. Дистилляция с малым числом шагов (few-step distillation) обучает модель получать результат за меньшее число итераций. Эти способы по-разному влияют на память, скорость и качество; один не заменяет другой.
Название CFG-distilled у официальных весов не означает автоматически «четыре шага и та же картинка». Отсутствие обычной негативной ветви и ускорение по временным шагам — разные вещи. Встречающиеся Turbo/Fast-варианты нужно проверять по автору, checkpoint и поддерживаемому режиму: ускорение FL не обязано работать с Reference. Например, конкретная интеграция FastH3 V2 в руководстве ComfyUI FastVideo описывает T2V и first/last, а не все возможные Reference-сценарии.
Для первой проверки оборудования начните с короткого ролика без склеек, одного человека и небольшого набора исходников. Сохраните настройки, затем постепенно увеличивайте длительность и добавляйте материалы по одному. Если сразу загрузить несколько роликов, звук и сложную раскадровку, будет трудно понять причину нехватки памяти или изменения лица.
Ограничения и проверка результата
Почему «всё что угодно» пока остаётся красивой гиперболой
H3 объединяет много способов постановки, но не устраняет неопределённость генерации. Модель может сохранить общую композицию и потерять форму кольца. Правильно передать движение головы и изменить зубы. Повторить темп речи, но исказить отдельное слово. Чем больше требований одновременно, тем труднее выполнить каждое.
Особенно чувствительны быстрые руки, прозрачные предметы, отражения, перекрытия лица, точные логотипы и длинные причинно связанные действия. Это не список доказанных неудач каждого ролика H3: это зоны, которые нужно проверять в своём материале, потому что они требуют устойчивости между кадрами, а не одной красивой картинки.
Контекст также способен противоречить сам себе. Несколько ракурсов одного героя помогают только тогда, когда это действительно один согласованный герой. Разные причёски, линзы, серьги и свет создают для модели задачу выбора. Иногда удаление одного плохого источника приносит больше пользы, чем увеличение числа референсов.
И наконец, редактирование не равняется восстановлению истины. Если камера никогда не показала заднюю сторону предмета, модель её достраивает. Такой результат годится для вымышленной сцены, но не становится документальным свидетельством о реально снятом объекте.
Как принять дубль, а не только красивый стоп-кадр
Короткая производственная проверка начинается с исходного задания. Сначала открывается карта ролей: что должно было измениться, что сохраниться, какой источник за что отвечал. Затем видео просматривается целиком, со звуком и без него. Это помогает не спутать эффектную музыку с качеством движения.
| Проверка | Что искать | Что менять при проблеме |
|---|---|---|
| Внешность | Дрейф профиля, волос, украшений и глаз при повороте | Согласовать ракурсы, убрать конфликтующий референс, упростить движение |
| Руки и предмет | Исчезновение конверта, смену хвата, слипание пальцев | Уточнить одно действие и видимость предмета; при необходимости разделить дубль |
| Новая одежда | Морфинг вместо готового образа, старый воротник | Закрепить костюм уже в первом кадре и явно отделить его от старого видео |
| Камера | Ненужные склейки, прыжок масштаба, смену направления | Назвать тип движения и структуру плана |
| Речь | Движение губ не у того персонажа, неверные слова, резкую смену голоса | Проверить, кому назначена реплика, нумерацию Audio и длину реплики |
| Сохранённый материал | Незаметную замену фона, музыки или важных деталей | Сузить область правки; критичные элементы сохранить обычным композитингом |
| Время и экспорт | Неверную частоту, длину или потерянную дорожку | Проверить загрузчик, кадровую сетку и финальный контейнер |
Для сравнения версий сохраняйте исходники, точный промпт, вариант весов, схему ComfyUI, seed и параметры. Один seed не гарантирует одинаковый результат в разных библиотеках или при разной точности весов. Эти изменения нужно учитывать при сравнении.
Открытые веса и лицензия: где проходят ограничения
MiniMax называет релиз open-source, однако H3 распространяется по собственной MiniMax H3 Community License, не по Apache или MIT. Поэтому здесь точнее говорить об открытых весах с особыми условиями, а не о свободе любого использования.
В проверенной редакции исключены ЕС, Великобритания, Республика Корея и США; для них требуется отдельное согласование. При годовой выручке коммерческих продуктов и сервисов свыше 20 млн долларов нужно предварительное письменное разрешение. В интерфейсе коммерческого продукта/сервиса с H3 необходимо заметно указывать MiniMax H3. Есть требования к распространению, уведомлениям и допустимому использованию.
Также запрещено улучшать другие AI-модели с помощью H3 или её результатов, кроме H3 и её производных. Права на выходные материалы не отменяют ответственности за лица, голоса, исходники и дальнейшее распространение. Россия не перечислена среди исключённых территорий, но это не самостоятельное юридическое заключение о любом сценарии. Перед коммерческим проектом нужно читать действующий текст и применимые правила, а спорные условия согласовывать с правообладателем. Полная лицензия, включая Acceptable Use Policy.
Первая ли она: H3, VACE и LTX решают разные задачи
Фраза «первая open-source контекстная видеомодель» слишком широка. До H3 уже существовала VACE, объединявшая генерацию и редактирование с визуальным контекстом, reference-to-video и masked video-to-video. Её статья появилась в марте 2025 года, позже были опубликованы веса и реализации. Поэтому история контекстного видеоредактирования не начинается с H3. Статья VACE, официальный репозиторий.
Из этого не следует, что H3 повторяет VACE. У H3 собственная связка текста, изображений, видео и аудио, совместная генерация звука и подробный язык отношений к источникам. Интереснее сравнивать какой именно контроль получает автор, а не присуждать абсолютное первенство неопределённой категории.
С LTX полезно проводить другую границу. В нашем разборе LTX-2.5 разобраны специализированные адаптеры — для прозрачности, HDR, реставрации и других задач. В H3 значительная часть управления выражается через общий контекст. Это не доказывает, что Reference выдаёт физически корректный HDR или готовую альфу только от соответствующего слова. Для таких выходов нужны подтверждённые форматы и подходящий процесс. Официальная коллекция LTX-2.5 Creative Lab.
| Что требуется | Как выбирать подход |
|---|---|
| Связать два согласованных кадра | Начать с FL2VA и описать путь между состояниями |
| Собрать внешность, движение и голос из источников | Рассмотреть Ref2VA и подготовить карту ролей |
| Точно ограничить область вмешательства | Проверить схему обработки с маской или композитинг, не надеяться только на фразу «не меняй остальное» |
| Получить специальный технический выход: alpha, HDR | Выбирать инструмент с подтверждённым форматом, а не по общему качеству демонстраций |
| Гарантировать неизменную дорожку или надпись | Сохранять критичный элемент при монтаже, не подвергая его повторной генерации |
Вопросы, выводы и источники
Вопросы, которые возникают перед первым проектом
Нужно ли обучать LoRA на каждого нового человека?
Для Reference-сценария — нет: изображения используются как входной контекст. LoRA нужна для другой формы адаптации. Если персонаж должен держаться в большой серии сцен, полезно сравнить оба подхода на собственном материале, а не считать референс автоматической заменой любого обучения.
Можно ли обойтись одним аудиофайлом без картинки и видео?
В текущей реализации Diffusers нужен хотя бы один визуальный референс — изображение или видео. Нативный узел ComfyUI не содержит такой же явной проверки, но принятие входа ещё не доказывает качество конкретного сценария. Поддержку комбинации нужно смотреть в документации своего клиента; редакция audio-only запуск не проверяла.
Как проверить результат без сложной метрики сходства?
Выбрать заранее несколько наблюдаемых условий и проверить начало, поворот, перекрытие лица и финал. Для речи отдельно прослушать слова и посмотреть артикуляцию. Это не заменяет полноценную приёмку, но быстро отделяет красивый общий образ от выполненной постановки.
Почему у одного промпта разные ограничения длины в разных местах?
Лимит может задавать клиент, API или схема запроса, а не сам трансформер. Например, ограничение в 7000 символов, встречающееся в серверных рецептах, не следует считать универсальным пределом каждой реализации H3. После перевода и добавления разметки нужно измерять именно отправляемый текст.
Можно ли считать облачный и локальный результат одним тестом?
Только если известна одинаковая цепочка подготовки, генерации и финальной обработки. Context-IR и Regenerate-2K не входят в открытые веса H3-Base. Поэтому сравнение «те же слова, но другая картинка» без сведений об этапах не изолирует качество базовой модели.
Умеет ли H3 делать полнометражное видео одним запросом?
Рассмотренные режимы рассчитаны на короткие клипы. Длинная работа собирается из планов с отдельной проверкой стыков, персонажей, звука и монтажного ритма. Большое значение в поле интерфейса не доказывает обучение модели на такой длительности.
Главное: описывать не только сцену, но и происхождение её частей
В H3 можно указать, откуда взять лицо, жесты, движение камеры и звук для новой сцены. FL2VA строит действие между заданными кадрами. Ref2VA позволяет выбрать свойства разных исходников и изменить нужную часть готового дубля.
Такая работа требует режиссёрской ясности: не «сделай похоже», а «внешность отсюда, движение отсюда, этот звук не копировать». Тогда и ошибки становятся понятнее. Можно исправлять конкретную связь, сохраняя удачную постановку, а не начинать поиск сцены заново.
Открытые веса позволяют запускать H3 на своём оборудовании в пределах лицензии, но не дают доступа ко всем этапам облачного сервиса. Начать можно с простой задачи — заменить одежду, сохранив один жест, — а затем проверить, какие требования удаётся совместить в вашем материале. О подготовке исходных образов рассказываем в статье об одном персонаже в разных кадрах, а о дальнейшем использовании видео — в разборе AI в кино.
Источники и границы исследования
Основные первичные материалы проверены на 22.10.2026. Ссылки рядом с утверждениями ведут к соответствующей части документации; этот список помогает продолжить изучение, а не заменяет доказательства в тексте.
- Первый материал MiniMax H3 — замысел системы и официальные демонстрации.
- Открытый релиз — состав опубликованной системы и архитектура.
- Официальный GitHub и веса MiniMaxAI — варианты, входы, компоненты и воспроизводимые примеры.
- Base prompt guide и Full-Reference guide — разные форматы постановки.
- ComfyUI: основной вход, native workflow, Multiframe — практические реализации.
- Diffusers, SGLang, vLLM-Omni — программный запуск и клиентские ограничения.
- Community License — юридические условия, имеющие приоритет над пересказами.
Мы не скачивали веса, не запускали H3 и не измеряли её скорость на собственной видеокарте. Два длинных промпта — наши учебные постановки, а не текст запросов официальных роликов. Три редакционные AI-иллюстрации не являются результатами H3. Официальные видео принадлежат MiniMax и подаются с источниками; превью получены из соответствующих роликов, а не сгенерированы вместо них.
Подписка Neurosaver
Получать новые разборы Neurosaver
Большие материалы выходят не каждый день, зато их стоит читать спокойно. Подпишитесь, и мы пришлём новые разборы и важные обновления словаря.
