Релизы
Qwen-Image-2.1: прозрачный фон, до 10 референсов и редактирование в одной модели
Полный перевод анонса Qwen-Image-2.1: генерация и редактирование изображений, работа с прозрачностью и объединение нескольких референсов. Сохранили все демонстрации авторов — 48 изображений и два видео.
Автор оригинала — QwenTeam. Опубликовано 20 сентября 2026 года. Перевод и пояснения редакции — Neurosaver. Читать оригинал на сайте Qwen.
Ниже — полный перевод статьи «Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation» с исходными демонстрациями. Заявления о качестве и скорости переданы от лица авторов. Изображения и видео размещены на хостинге Qwen; надписи внутри оригинальных изображений оставлены без изменений. Редакционное примечание после перевода отделено от текста разработчиков.
Qwen-Image-2.1: компактная и эффективная модель для создания изображений
Мы представляем Qwen-Image-2.1 — модель семейства Qwen, в которой стремились сбалансировать качество изображений, скорость работы и вычислительные затраты. Она объединяет генерацию по текстовому описанию и редактирование изображений. Генеративная визуальная часть содержит всего 7 миллиардов параметров, а создание и редактирование изображений с прозрачностью поддерживается непосредственно самой моделью.
В этом обновлении четыре основных улучшения:
- Компактность и эффективность. Облегчённая архитектура и оптимизация инференса помогают сочетать качество изображений с умеренными вычислительными затратами.
- Встроенная прозрачность, единая генерация и редактирование. По запросу можно создавать обычные изображения или изображения с прозрачностью, редактировать прозрачные слои и извлекать объекты из фотографий.
- Разнообразные возможности редактирования. Модель принимает до 10 референсов, позволяет задавать локальные изменения, сохранять особенности людей и товаров и решать разные типы задач.
- Реалистичные фактуры и более точная работа с визуальным оформлением. Улучшены типографика, свет в портретах и мелкие детали, от которых зависит убедительность изображения.
Компактность и эффективность
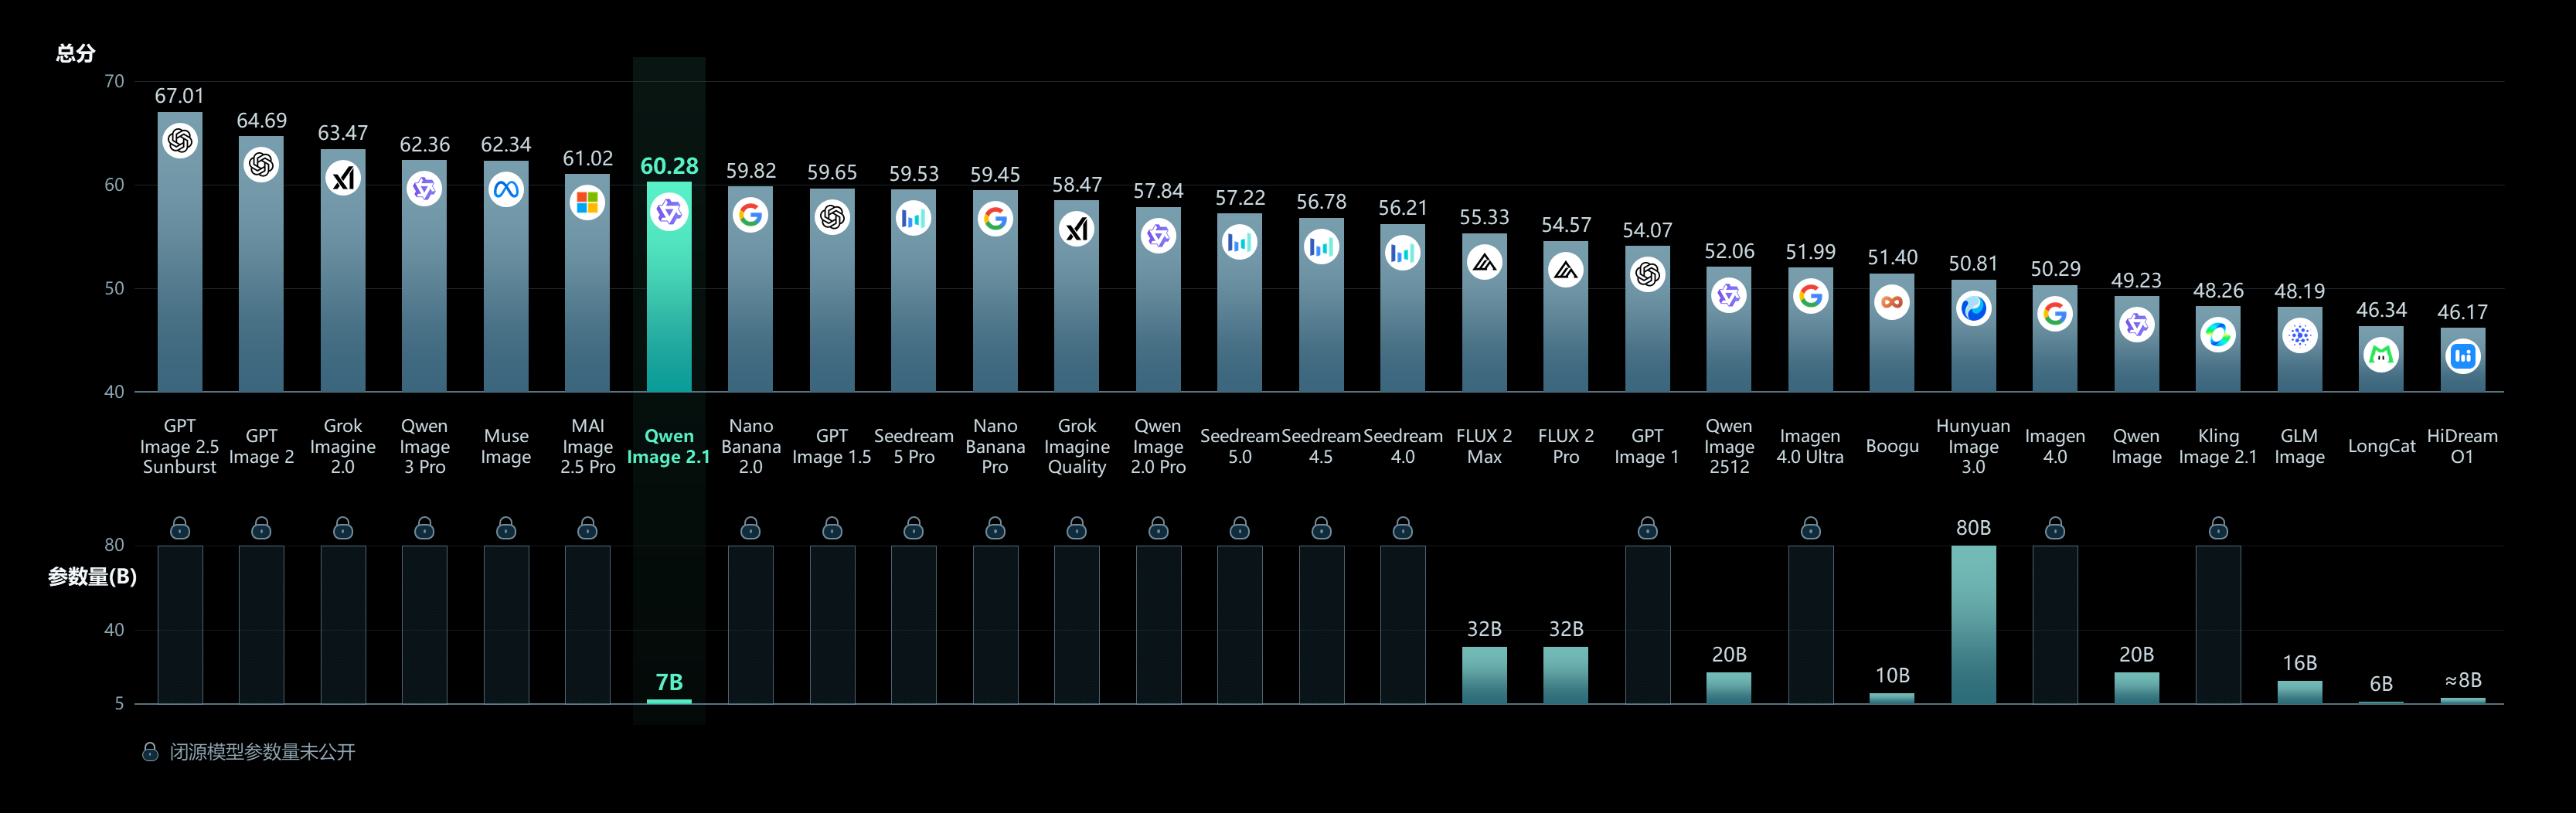
В основе Qwen-Image-2.1 — облегчённая архитектура. Её генеративная визуальная часть состоит из 32 слоёв Single-Stream DiT и содержит 7 миллиардов параметров. Несмотря на компактный размер, модель показывает высокое качество генерации. На графике Qwen-Image-Bench ниже её результаты сопоставлены с другими открытыми и закрытыми моделями.
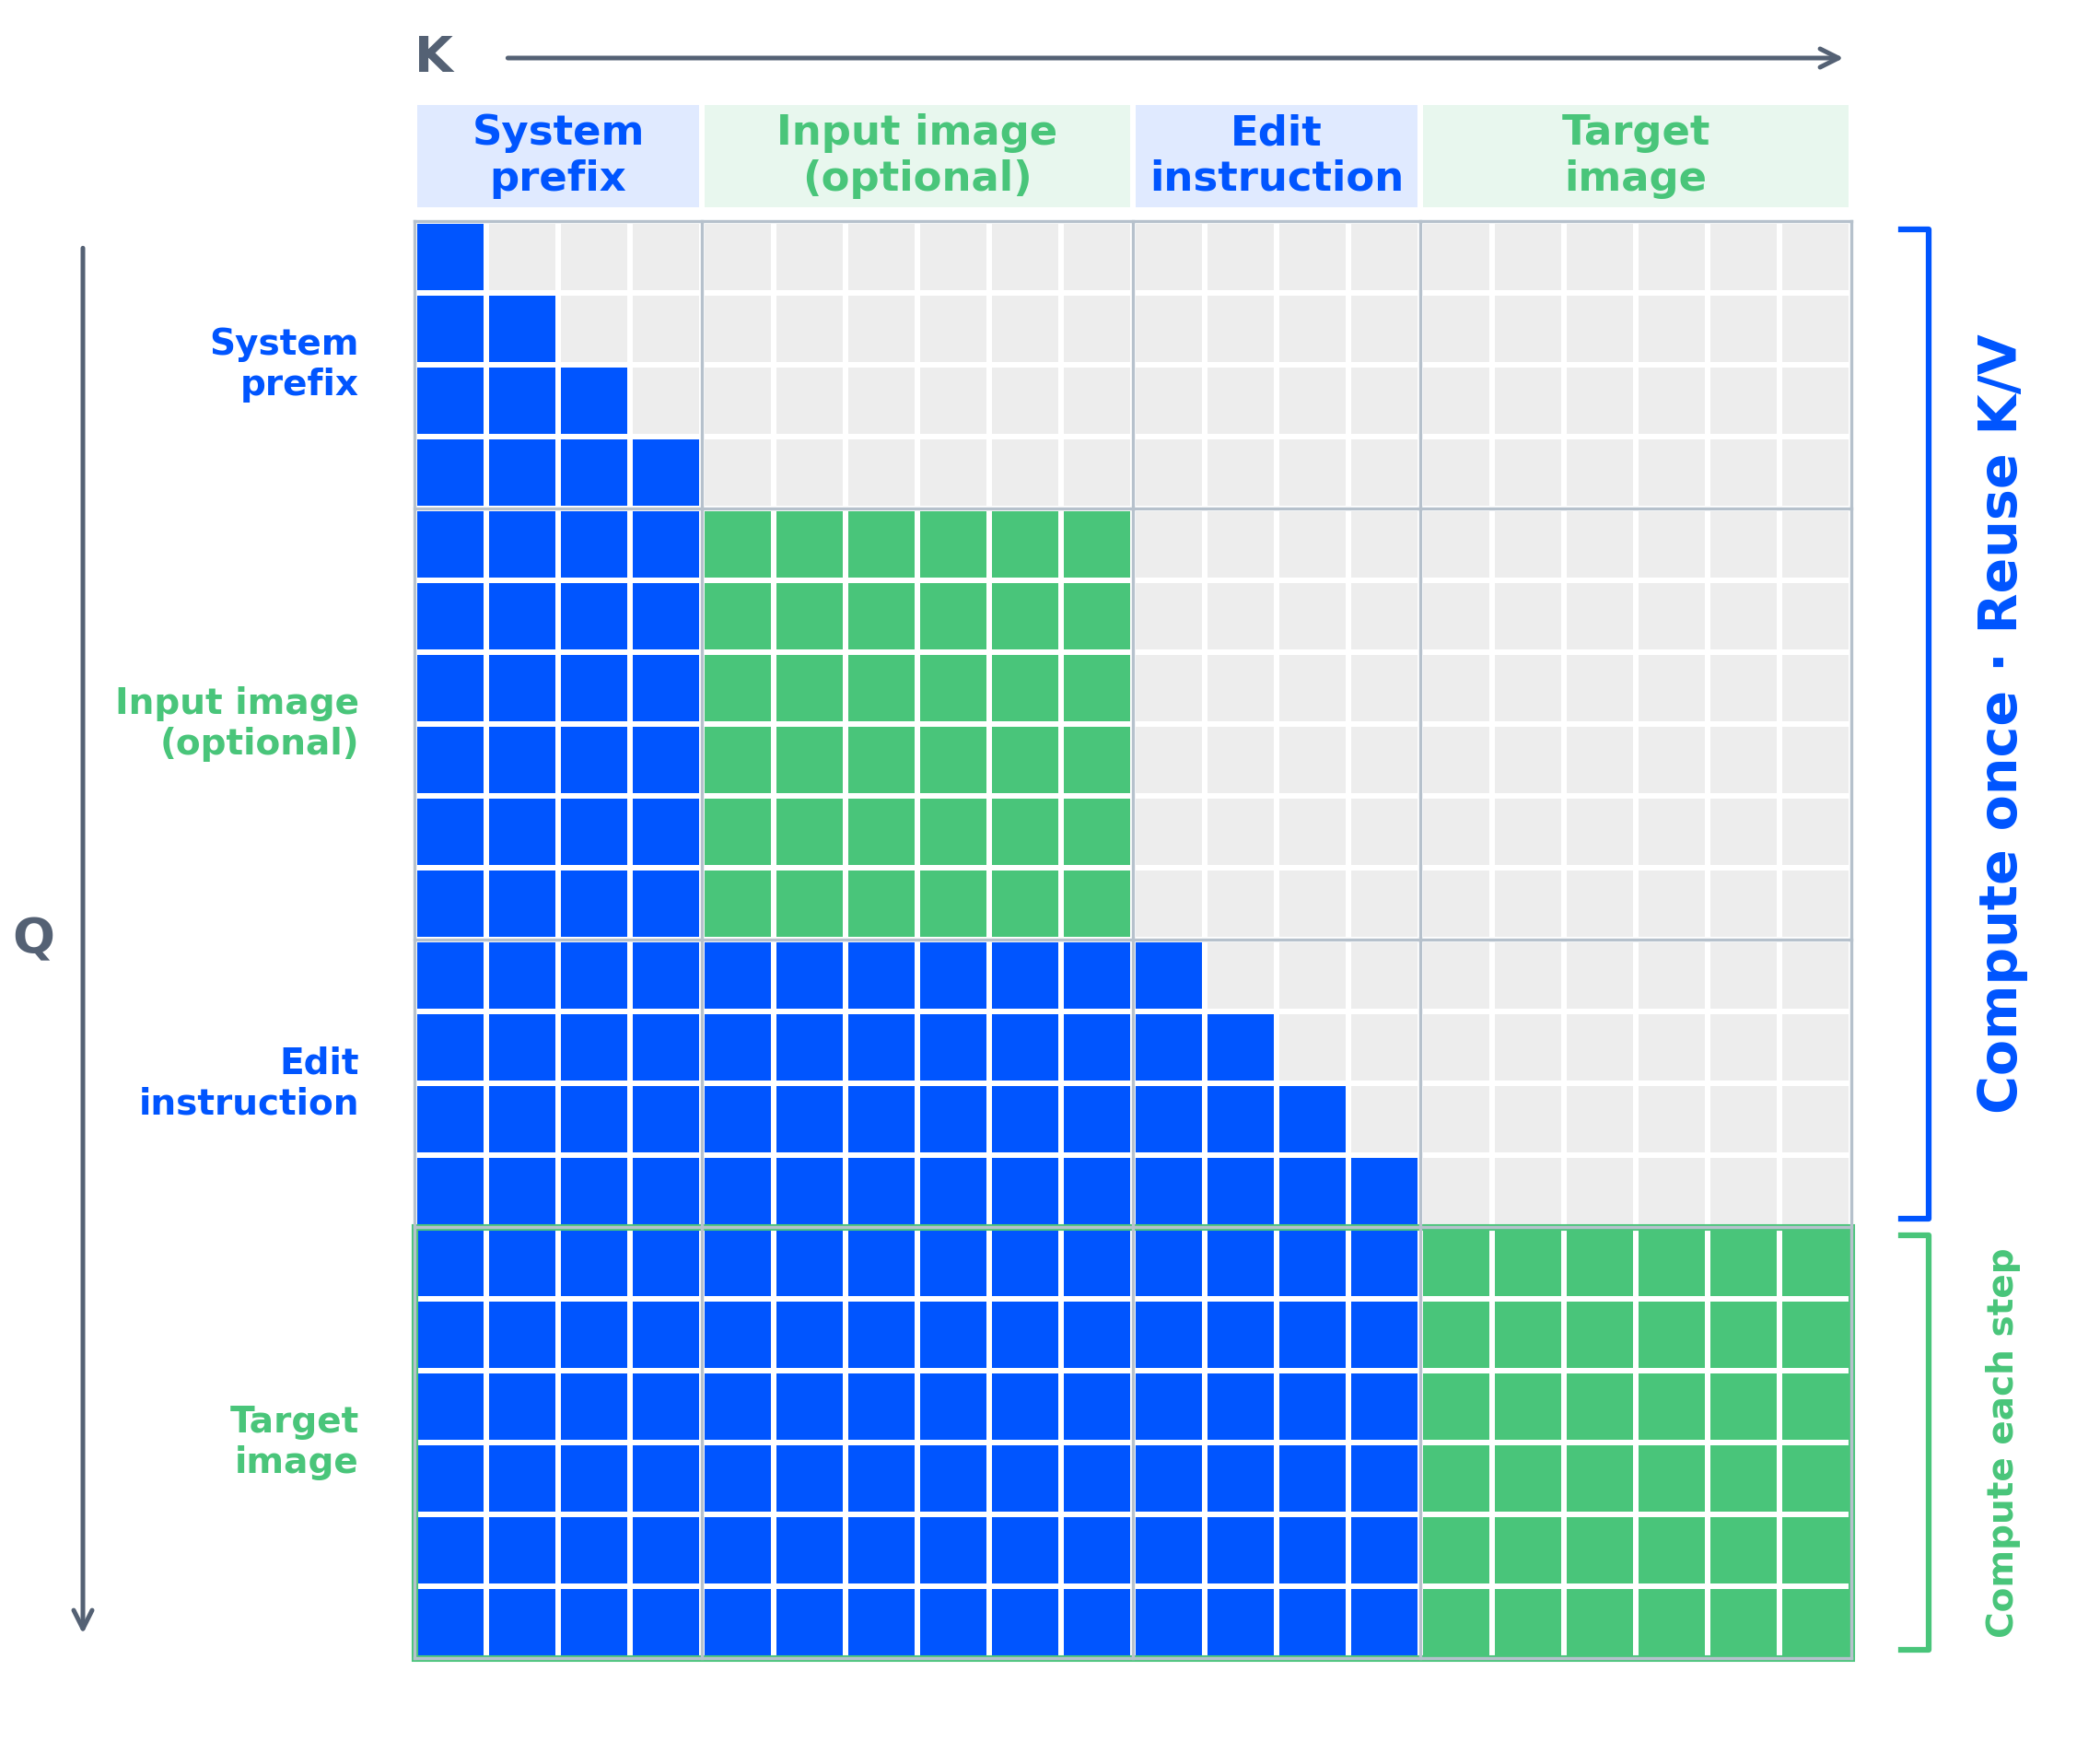
Ещё одно направление работы — эффективность инференса, особенно при редактировании с несколькими входными изображениями. Для этого используется архитектура внимания с разной гранулярностью. Текст, включая системный префикс и инструкции редактирования, обрабатывается с причинной маской на уровне токенов, а генерация изображения — с маской на уровне блоков.
Повторное использование KV-кэша позволяет рассматривать входные изображения и инструкции как неизменный контекст: он вычисляется и сохраняется в кэш на первом шаге. Это повышает эффективность инференса и уменьшает расход памяти.
Встроенная прозрачность: создание и редактирование в одной модели
Поддержка прозрачности — одно из главных дополнений этого выпуска. В декабре 2025 года мы представили Qwen-Image-Layered, отдельную модель для генерации изображений с прозрачностью. Теперь Qwen-Image-2.1 включает эту возможность в общую модель: запрос определяет, будет ли результат обычным изображением или изображением с каналом прозрачности.
Вот примеры прозрачных изображений, созданных непосредственно по тексту:
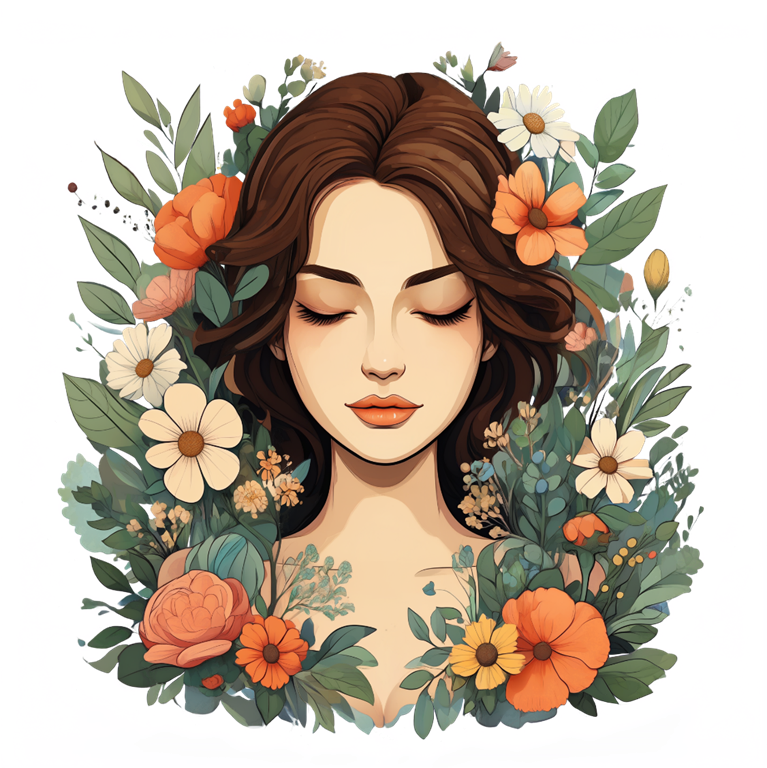
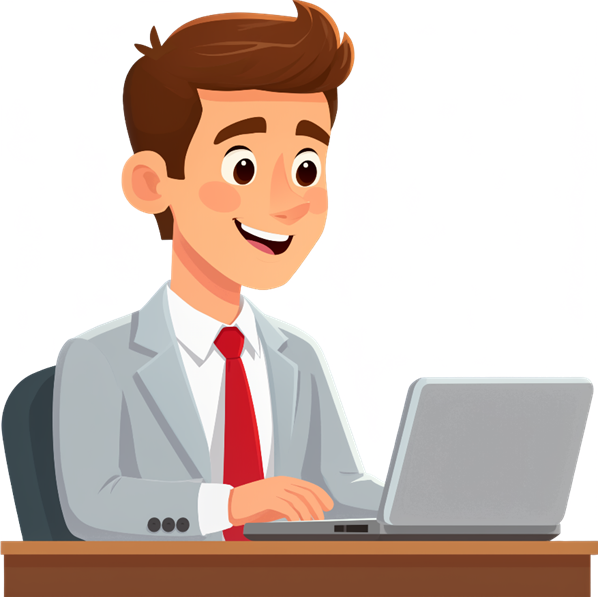
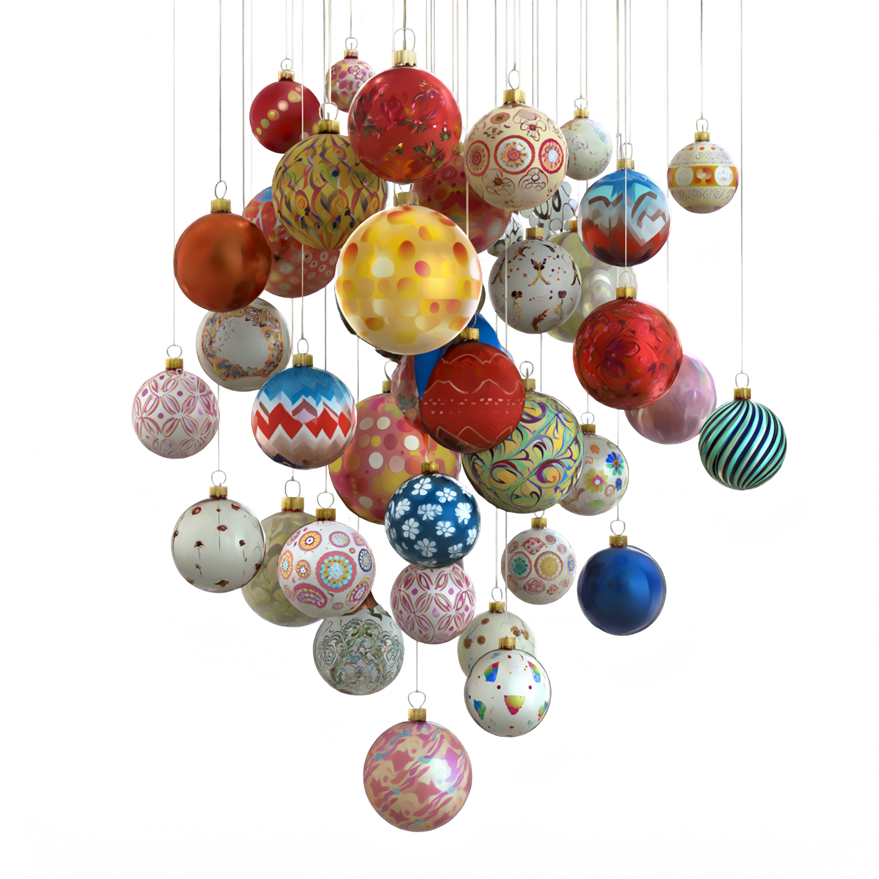
Модель может генерировать не только отдельные объекты, но и более сложные прозрачные композиции из нескольких элементов. Это расширяет возможности для дизайна и создания графических материалов.

Объединение генерации и редактирования позволяет непосредственно изменять прозрачные изображения. Например, можно поменять выражение лица персонажа, сохранив прозрачный фон. Слева показан исходник, справа — результат.


Текст внутри прозрачного слоя тоже можно редактировать. В следующем примере надпись «BLOOM» заменена на «Qwen-Image».


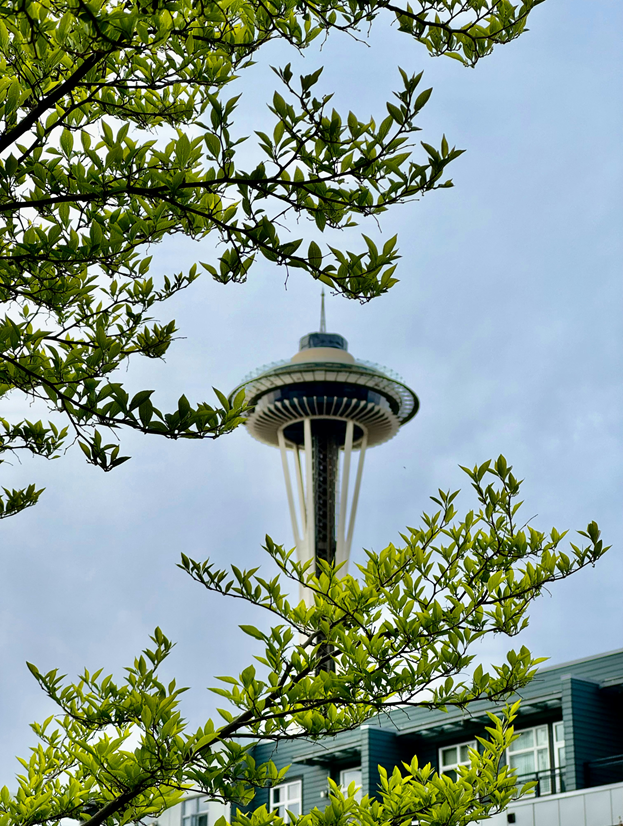
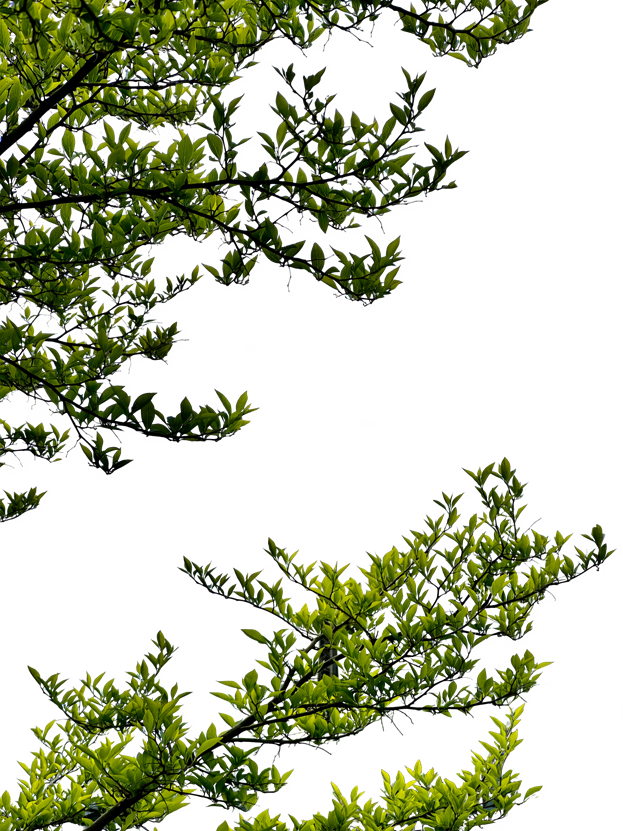
Эта возможность работает и с реальными фотографиями. Из RGB-изображения модель может извлечь нужный объект в отдельный RGBA-слой с прозрачностью. Такой элемент удобнее использовать в дальнейшей работе над дизайном и композицией.
Возможности редактирования
В Qwen-Image-2.1 улучшены четыре направления: работа с несколькими референсами, локальное редактирование, сохранение исходных особенностей и разнообразие поддерживаемых задач.
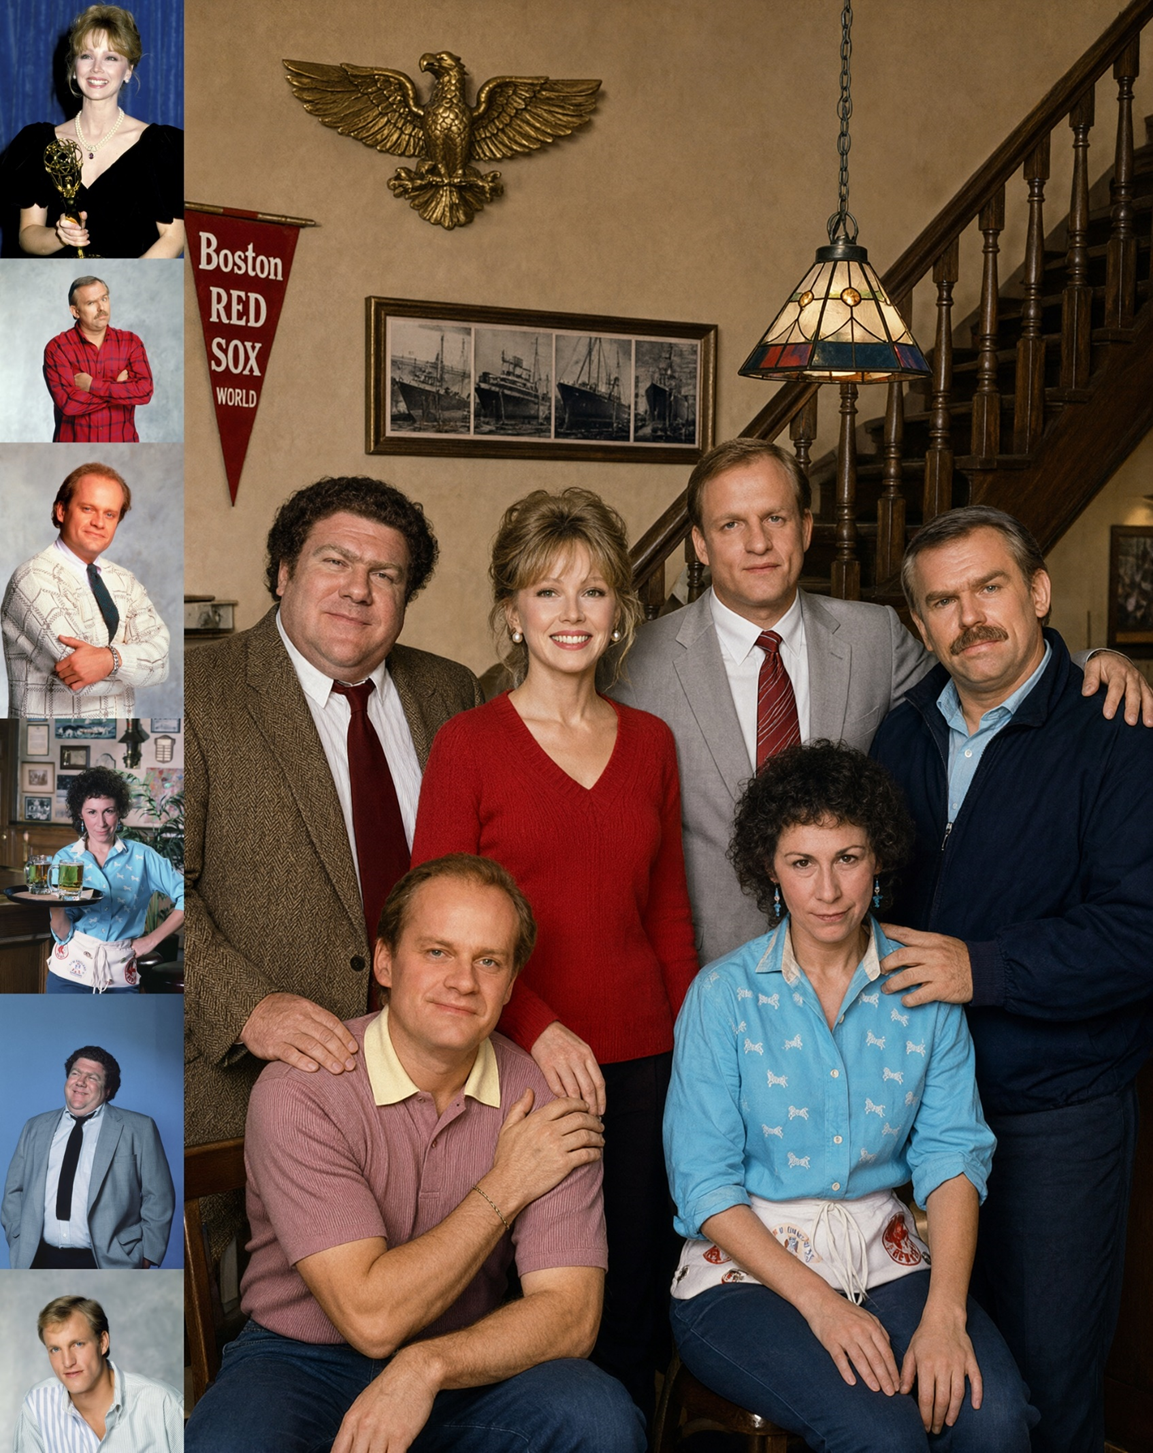
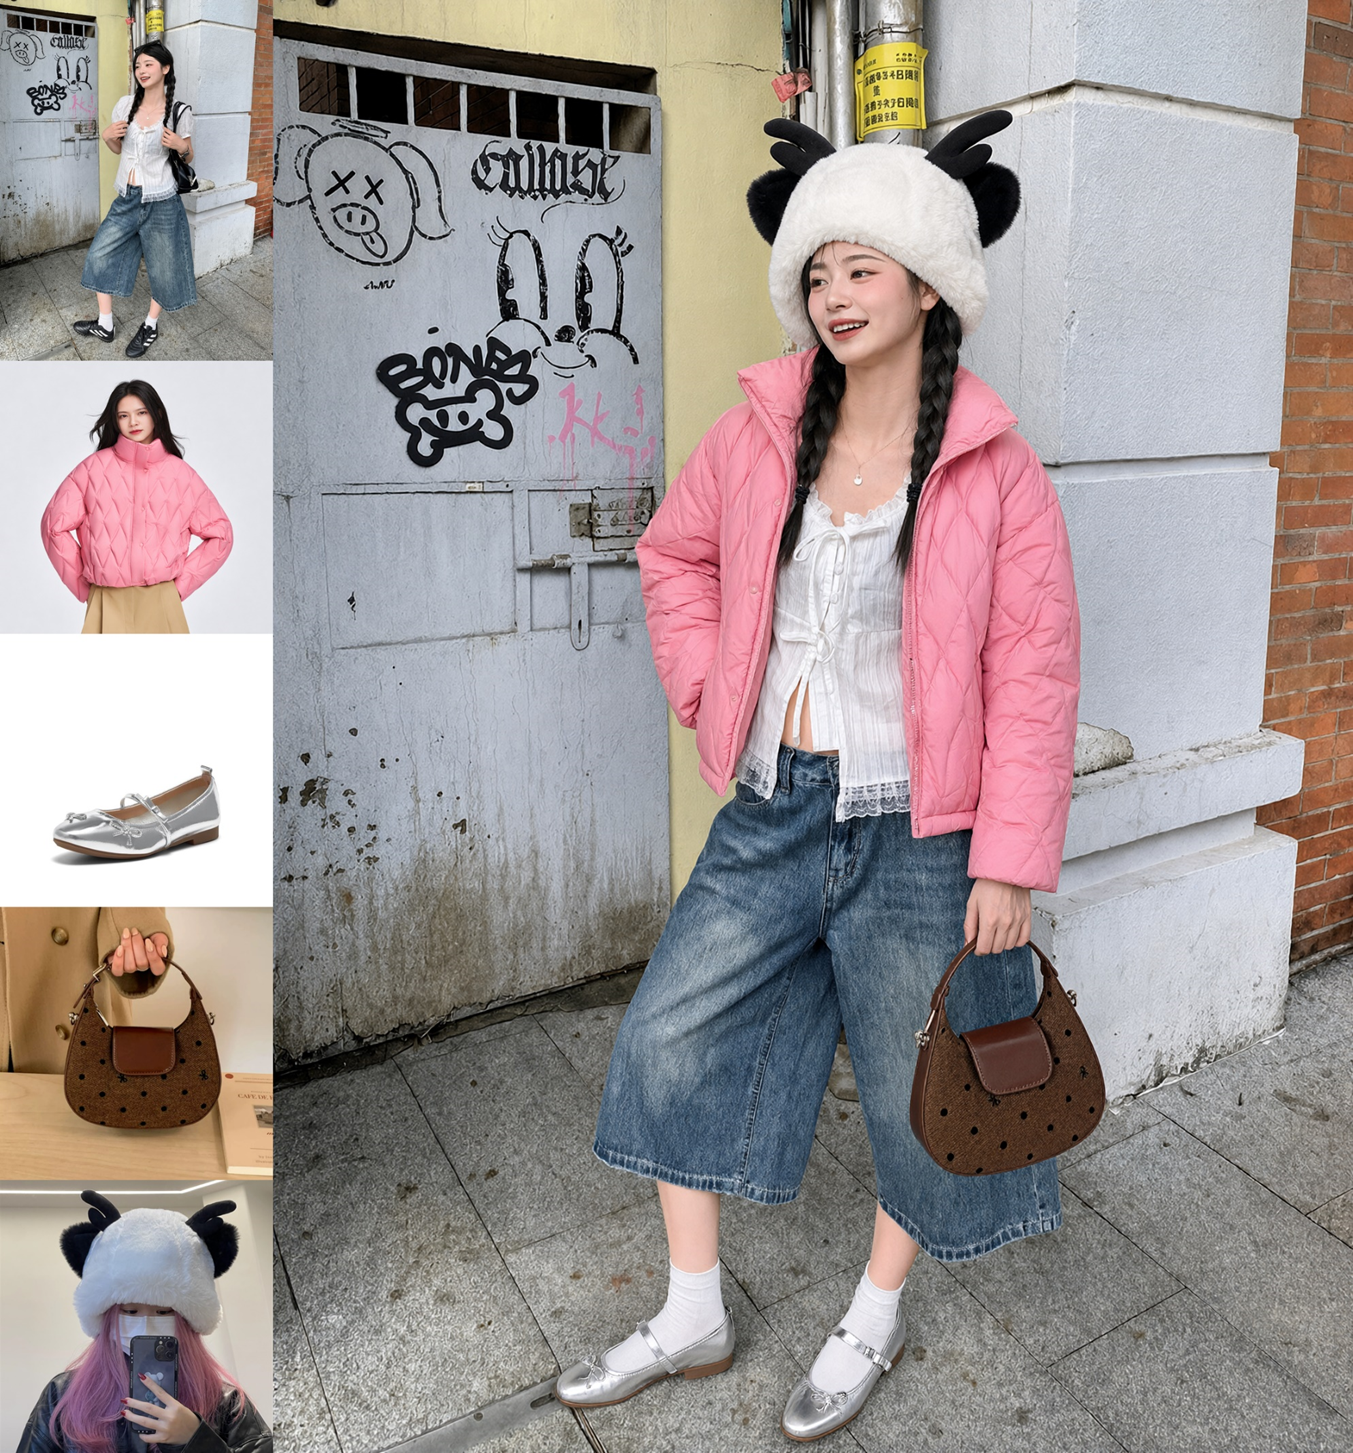
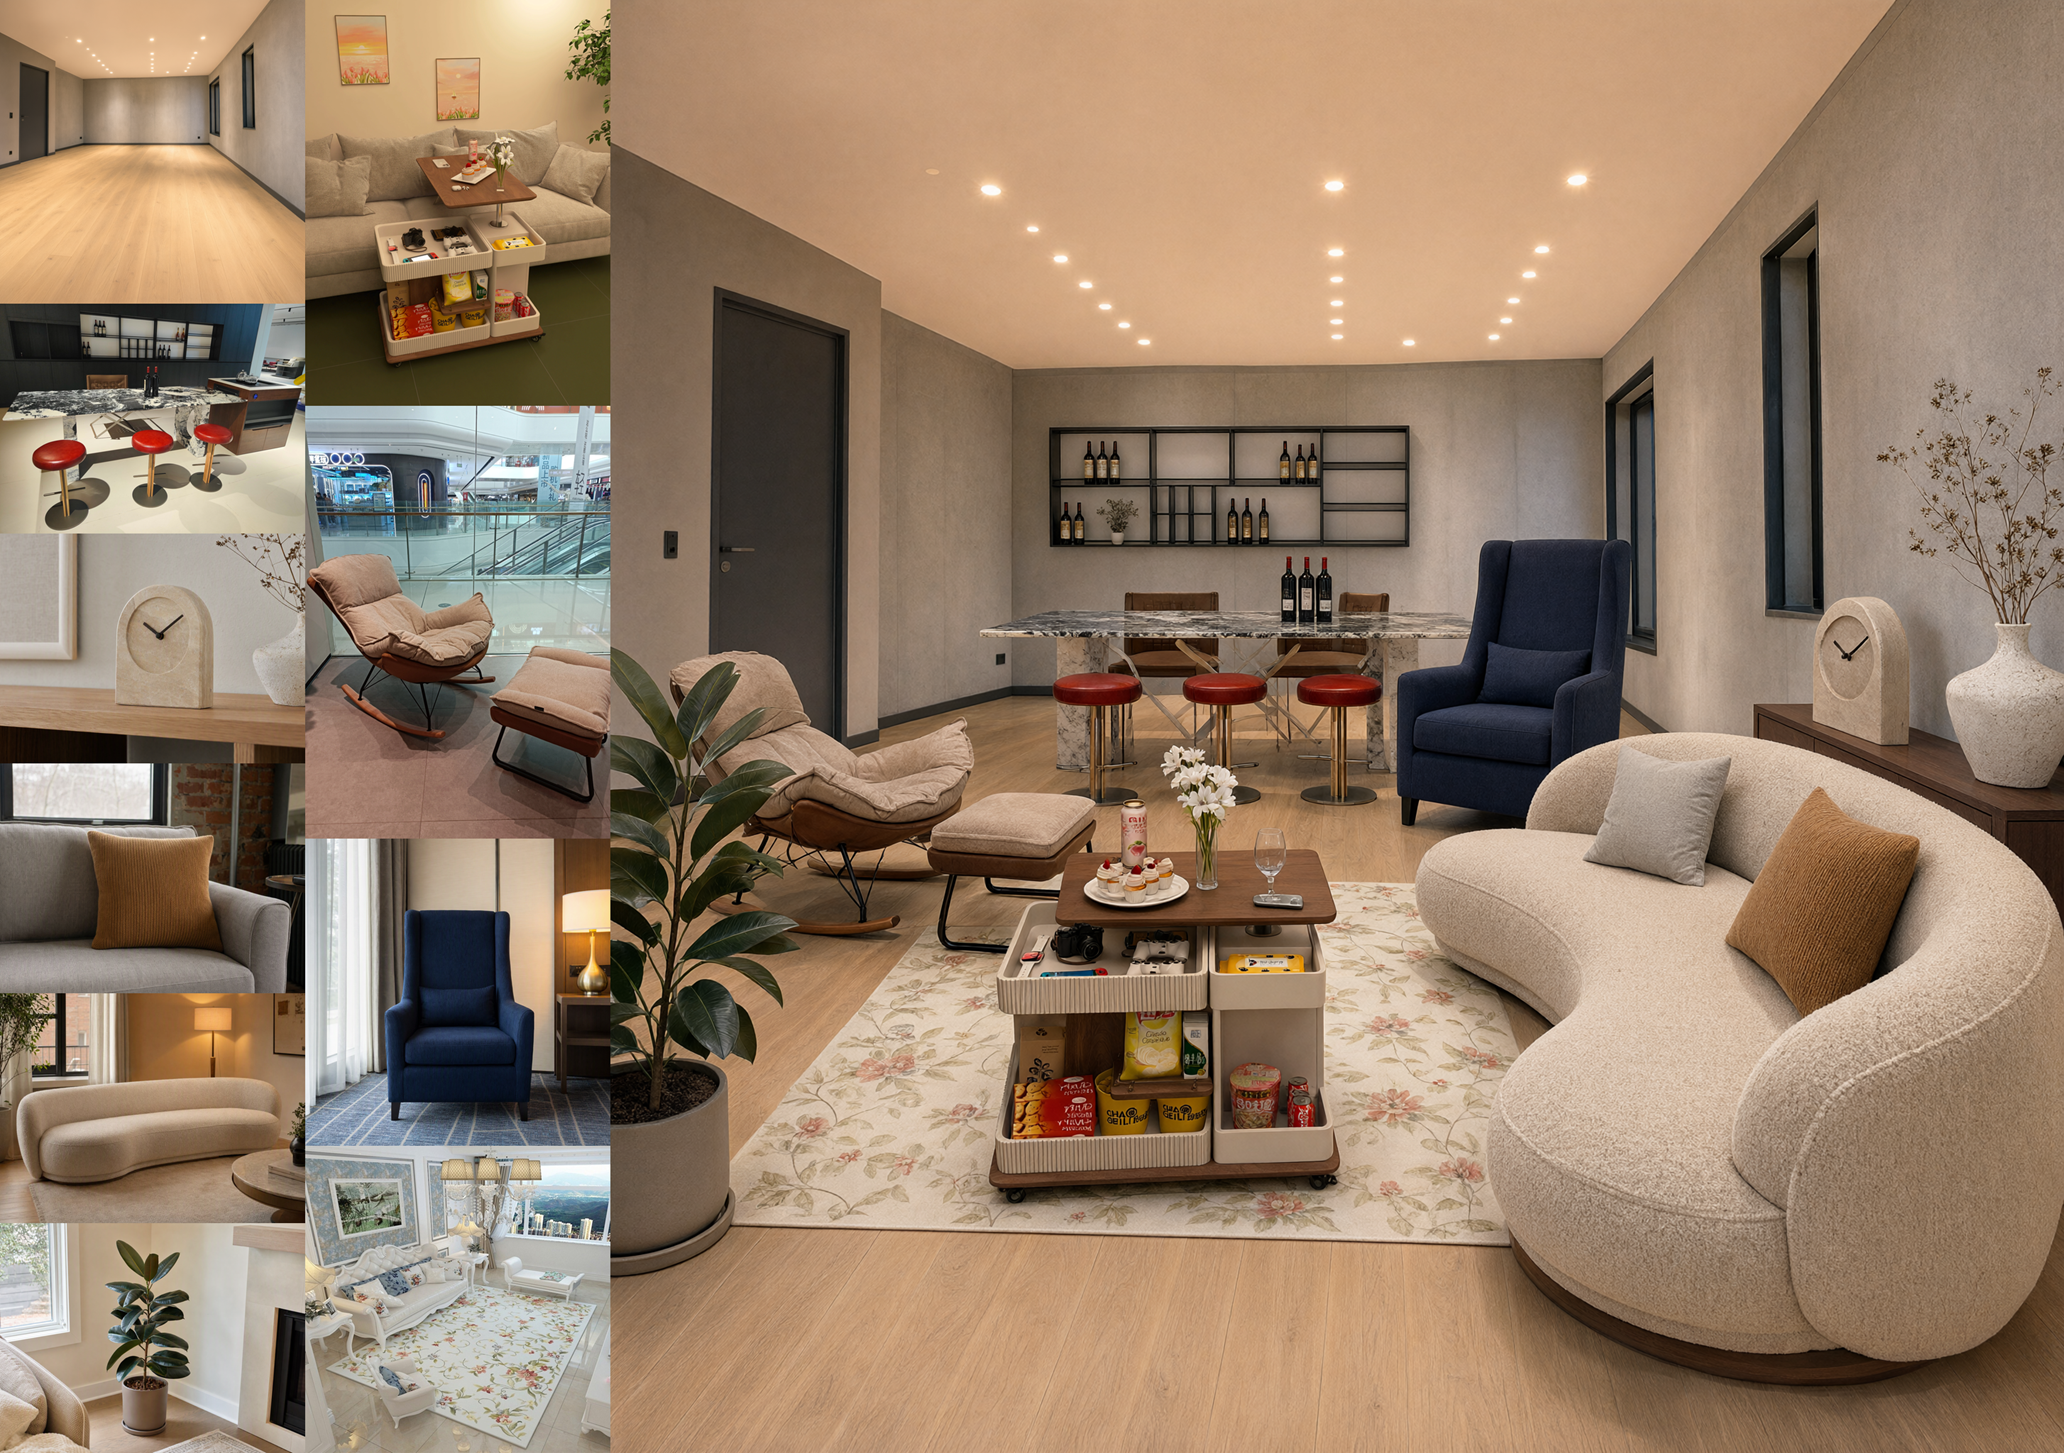
Несколько референсов: до 10 входных изображений
Qwen-Image-2.1 поддерживает до 10 изображений-референсов и объединяет несколько персонажей и объектов в цельную композицию. В примере ниже шесть отдельных портретов, показанных слева, собраны в одну групповую фотографию.
Для виртуальной примерки можно объединить пять исходников — фотографию модели, одежду, обувь, сумку и головной убор — в законченный образ.
В дизайне интерьеров модель может использовать 10 изображений предметов обстановки, чтобы создать готовую композицию комнаты.
Локальное редактирование: разные способы выделить область
Qwen-Image-2.1 позволяет указывать место изменения с помощью обводки, закрашенных областей или отдельных масок.
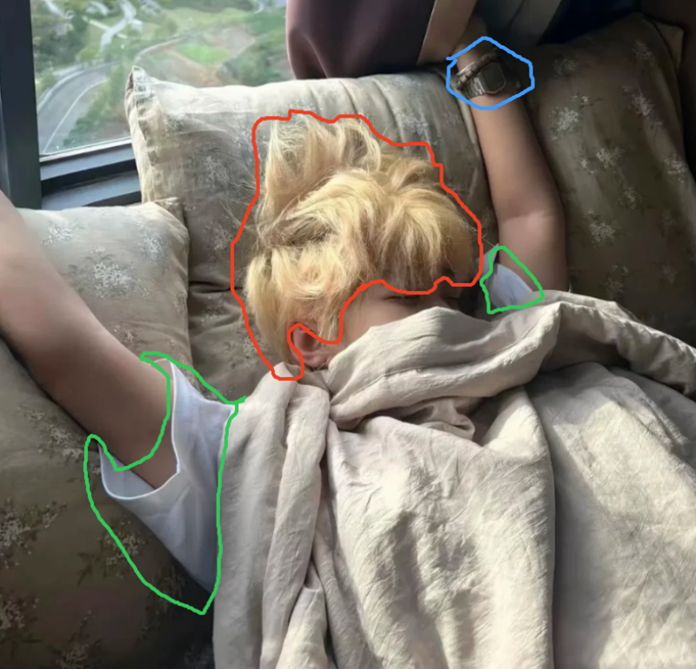
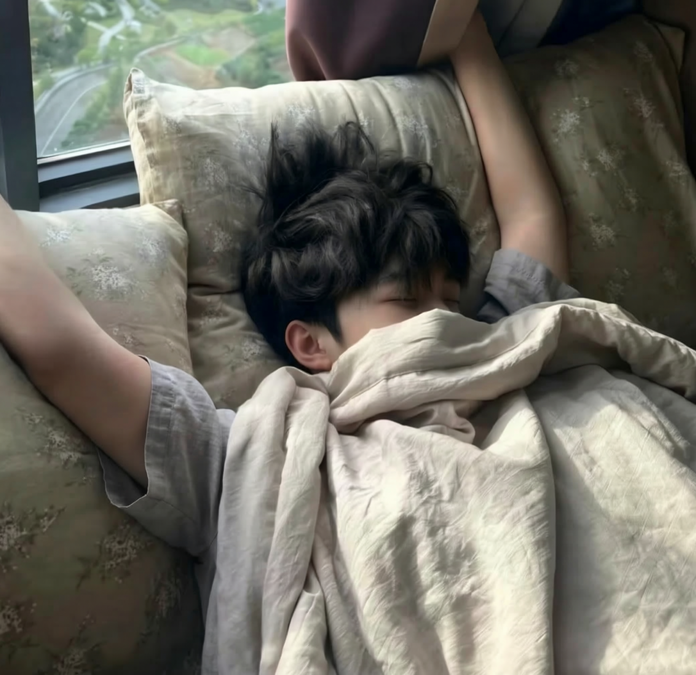
В первом примере обводки разных цветов обозначают сразу три области: «Убери металлические часы в синем круге, сделай волосы в красном круге чёрными и замени область в зелёном круге на серую льняную пижаму с короткими рукавами». Слева — исходник с разметкой, справа — результат.
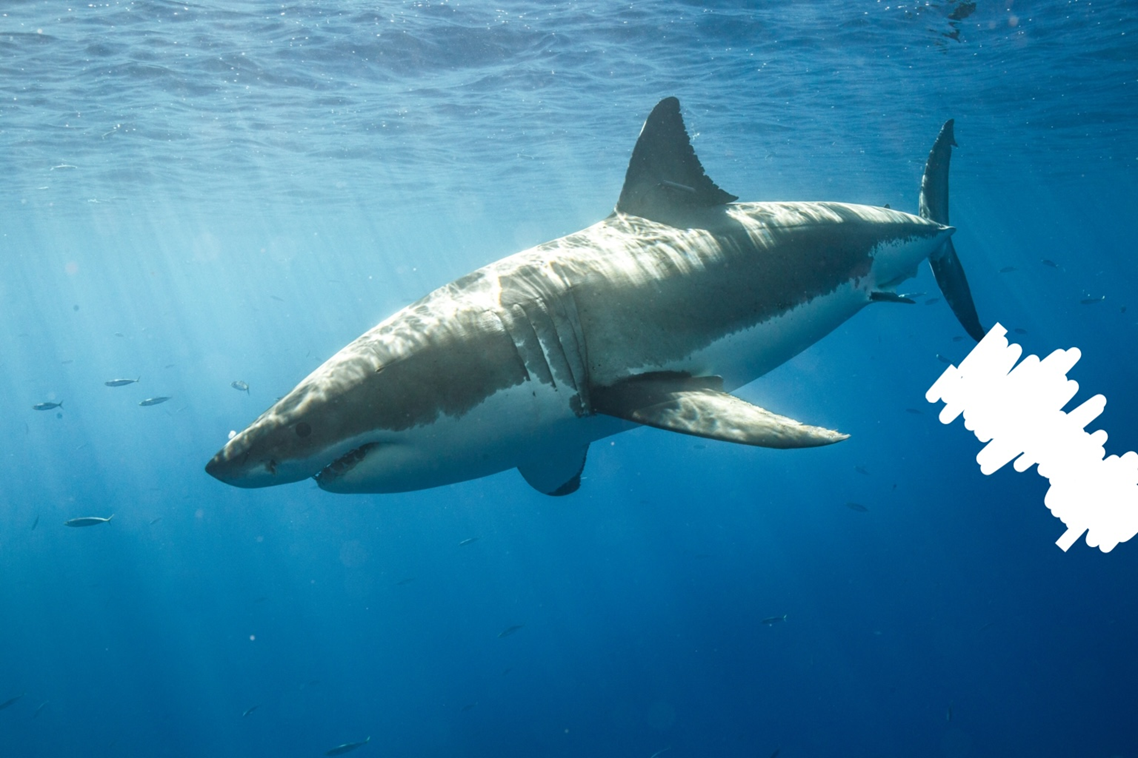
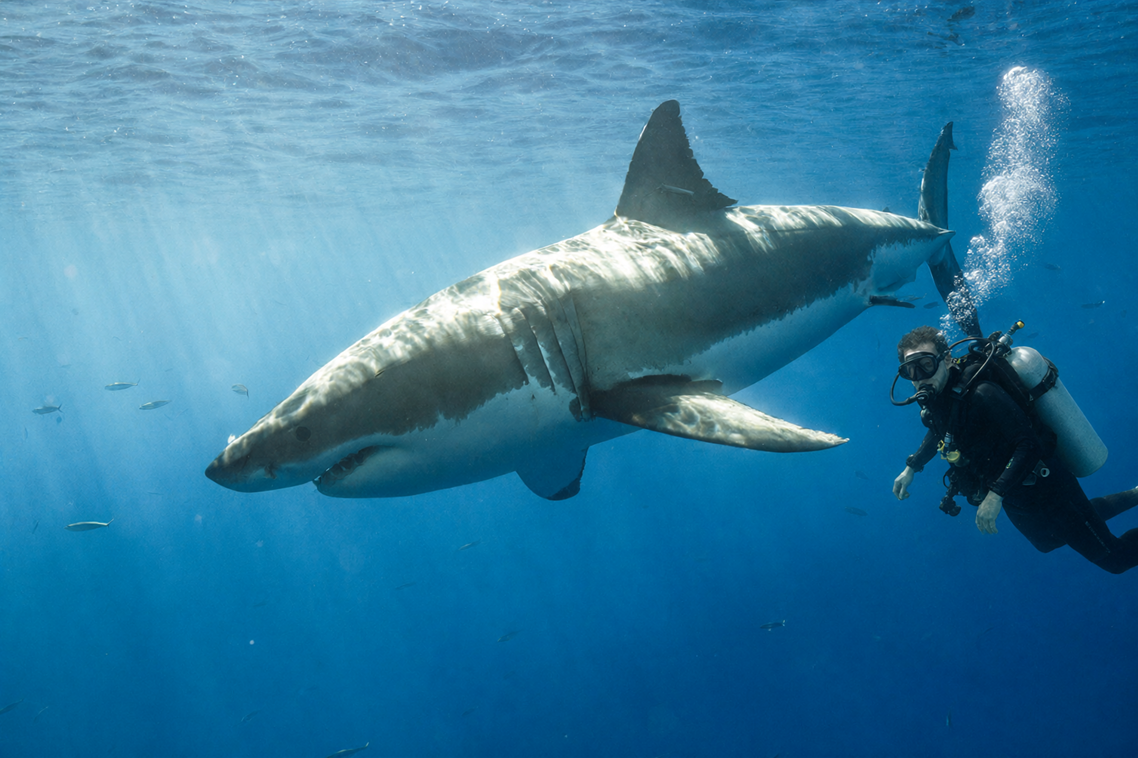
Другой способ указать область — закрасить её. В этом примере модель добавляет дайвера в место, отмеченное белым справа на исходном изображении.
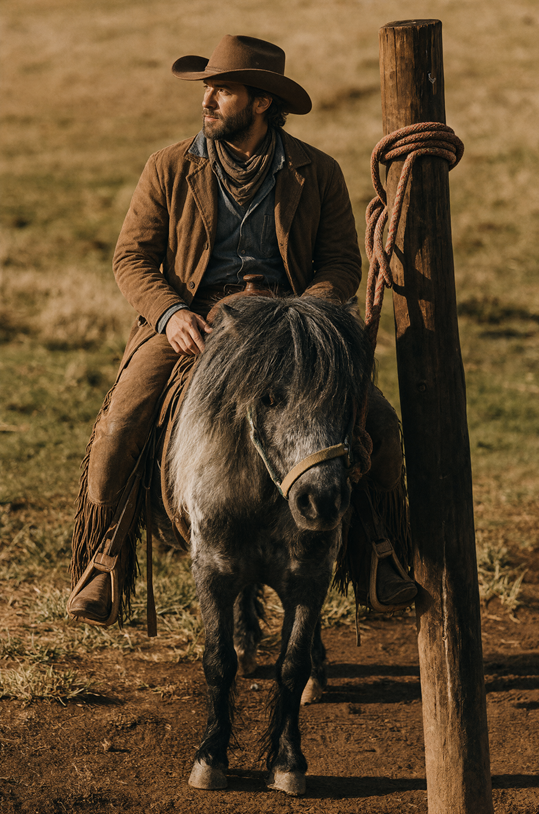
Обводка и закрашивание закрывают часть исходного изображения. Чтобы сохранить его целиком, Qwen-Image-2.1 также принимает оригинал и отдельную маску как два входных изображения. В следующем примере модель просят создать ковбоя верхом на лошади, используя эти два исходника:
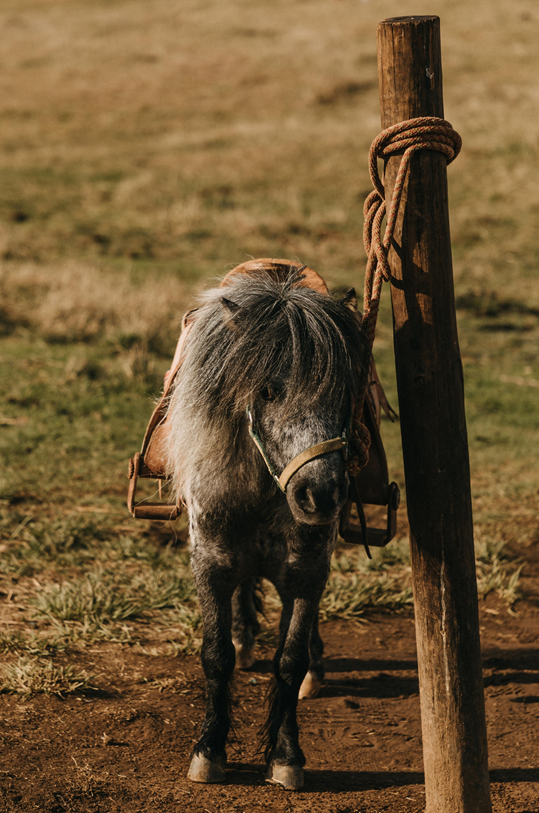
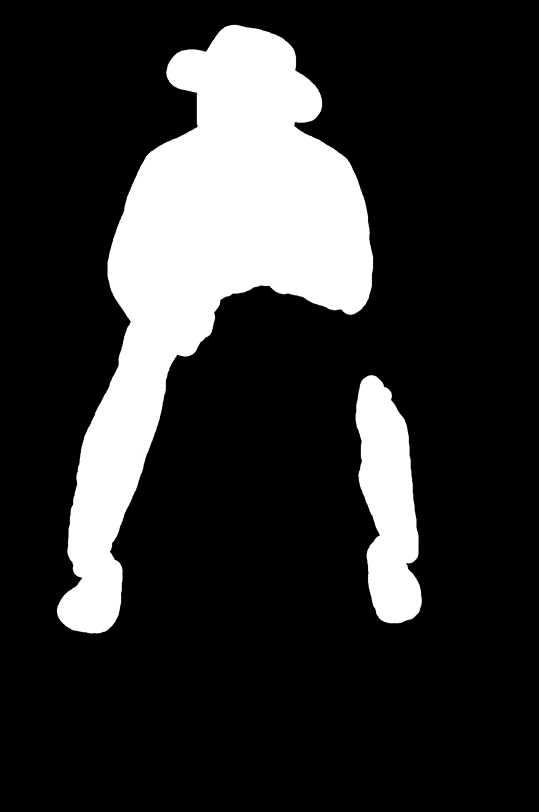
Модель изменяет область, заданную маской, и получает такой результат:
Локальное редактирование подходит и для последовательного создания сцены. Если вносить изменения одно за другим, сохраняя остальные части изображения, полученные кадры можно собрать в простую анимацию. Ниже — пример с капибарами в образах героев «Братьев-тыкв» (Calabash Brothers).
Сохранение исходных особенностей: люди и товары
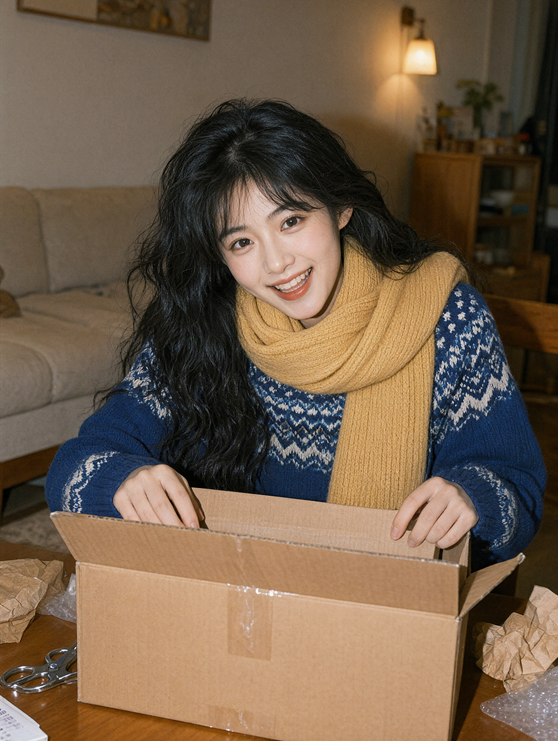
Улучшения в этой области касаются узнаваемости людей на портретах и постоянства внешнего вида товаров. При работе с портретами модель лучше сохраняет черты лица, чтобы человек оставался узнаваемым после редактирования. В каждой паре ниже слева находится исходник, справа — изменённое изображение.
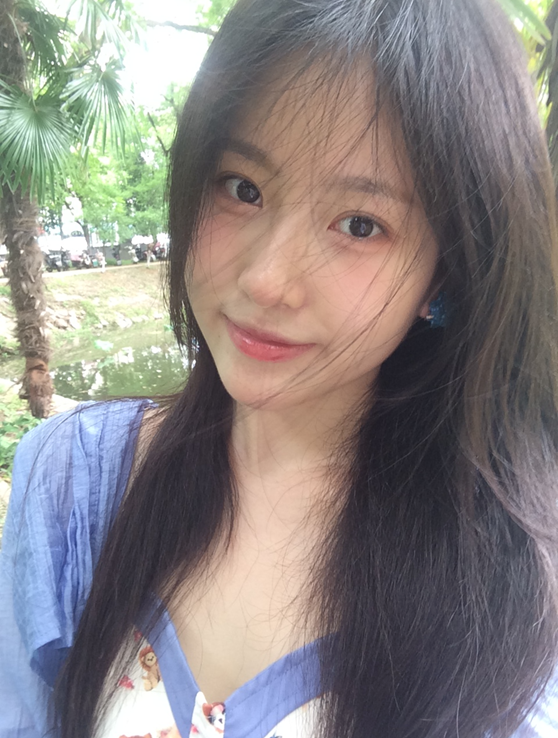
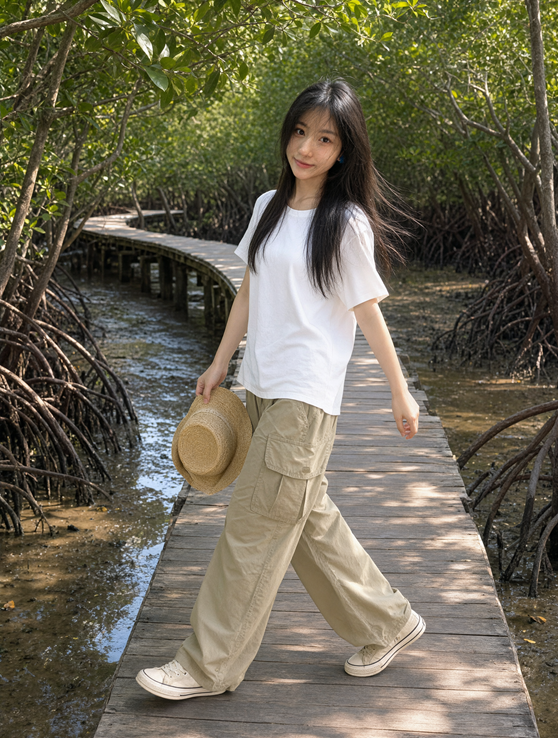
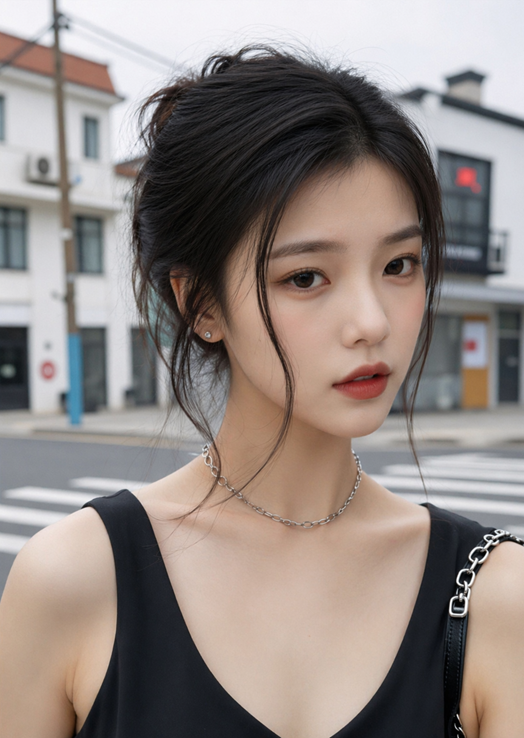
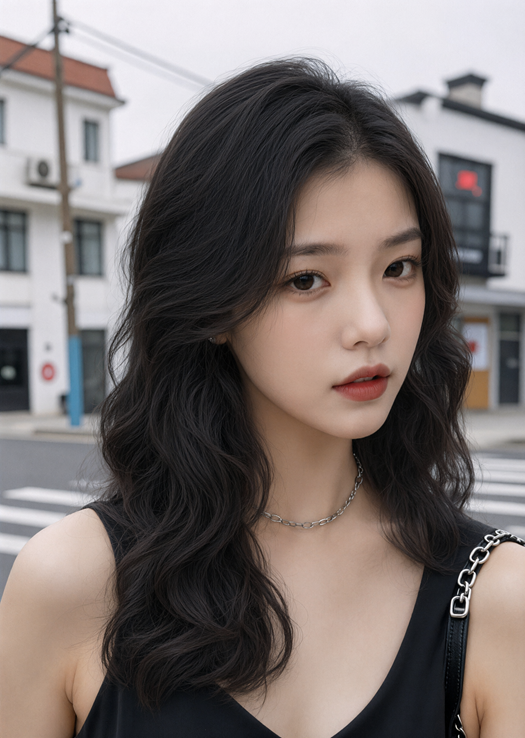
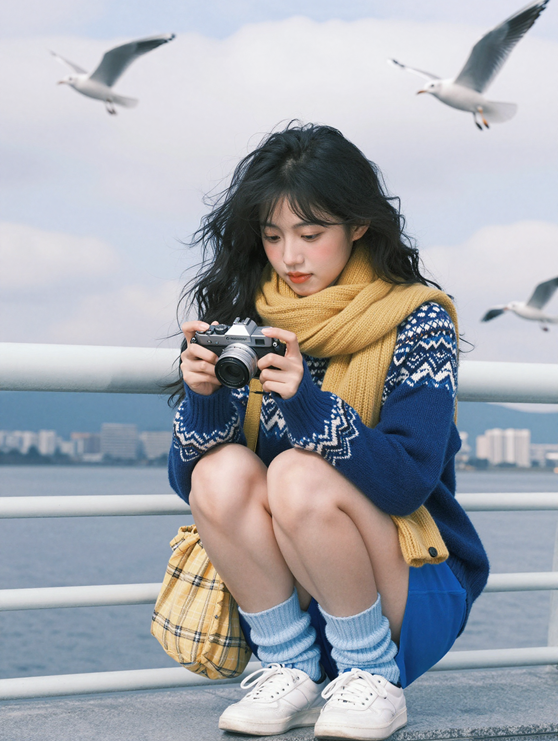
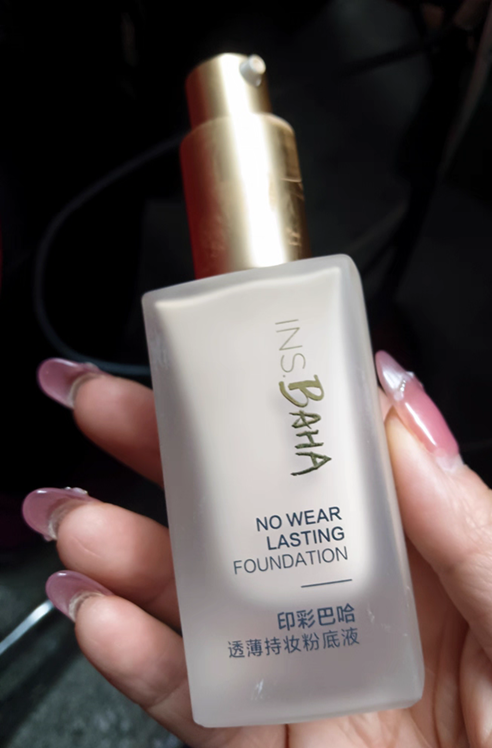
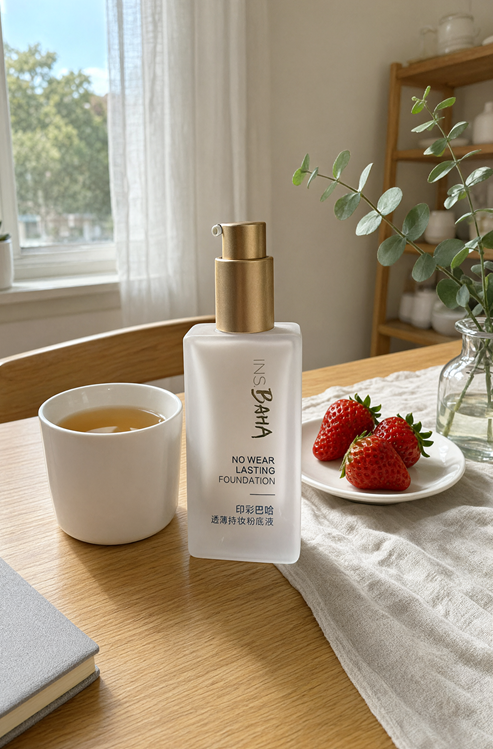
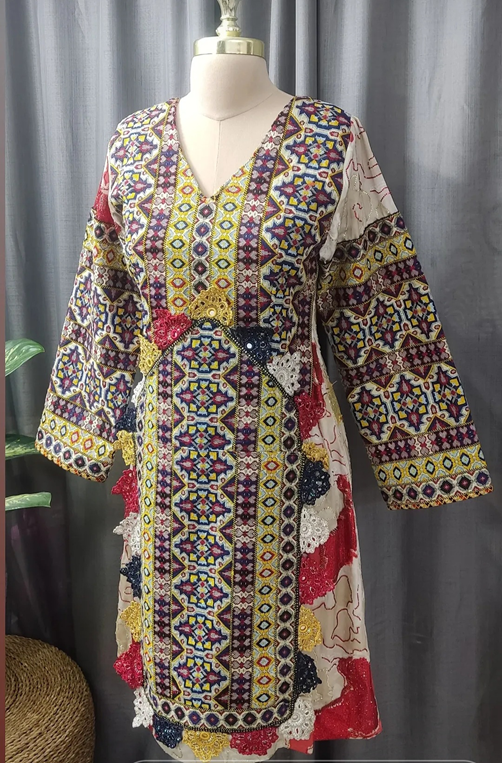
При редактировании изображений товаров модель стремится сохранять надписи, фактуры и форму, чтобы характерные особенности предмета оставались такими же и в новой сцене.
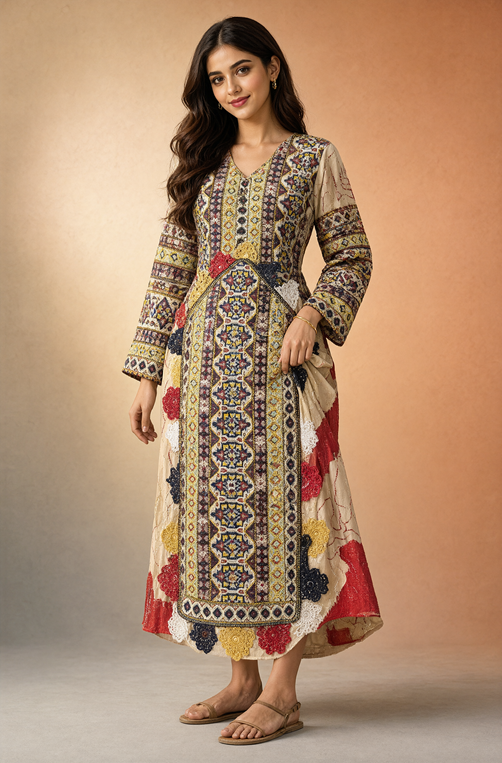
Разные задачи: панорамы, инфографика и раскадровки
Qwen-Image-2.1 поддерживает широкий набор задач редактирования, включая создание панорам, инфографики и раскадровок. Мы стремились сбалансировать возможности модели для разных сценариев применения.
Например, на вход можно подать такое селфи:
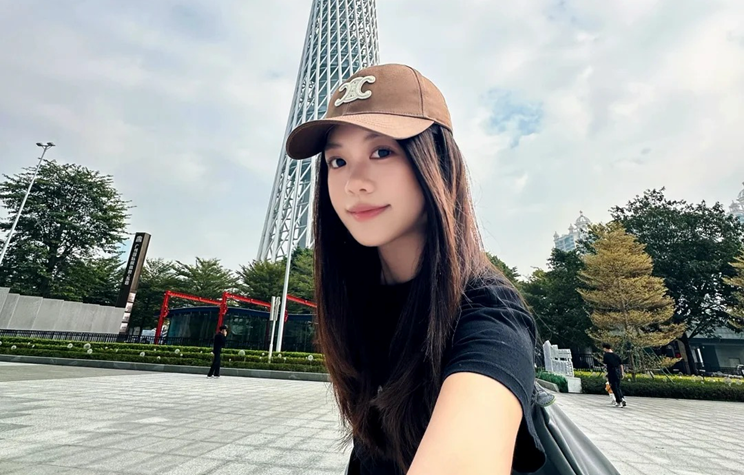
И получить следующую панораму:
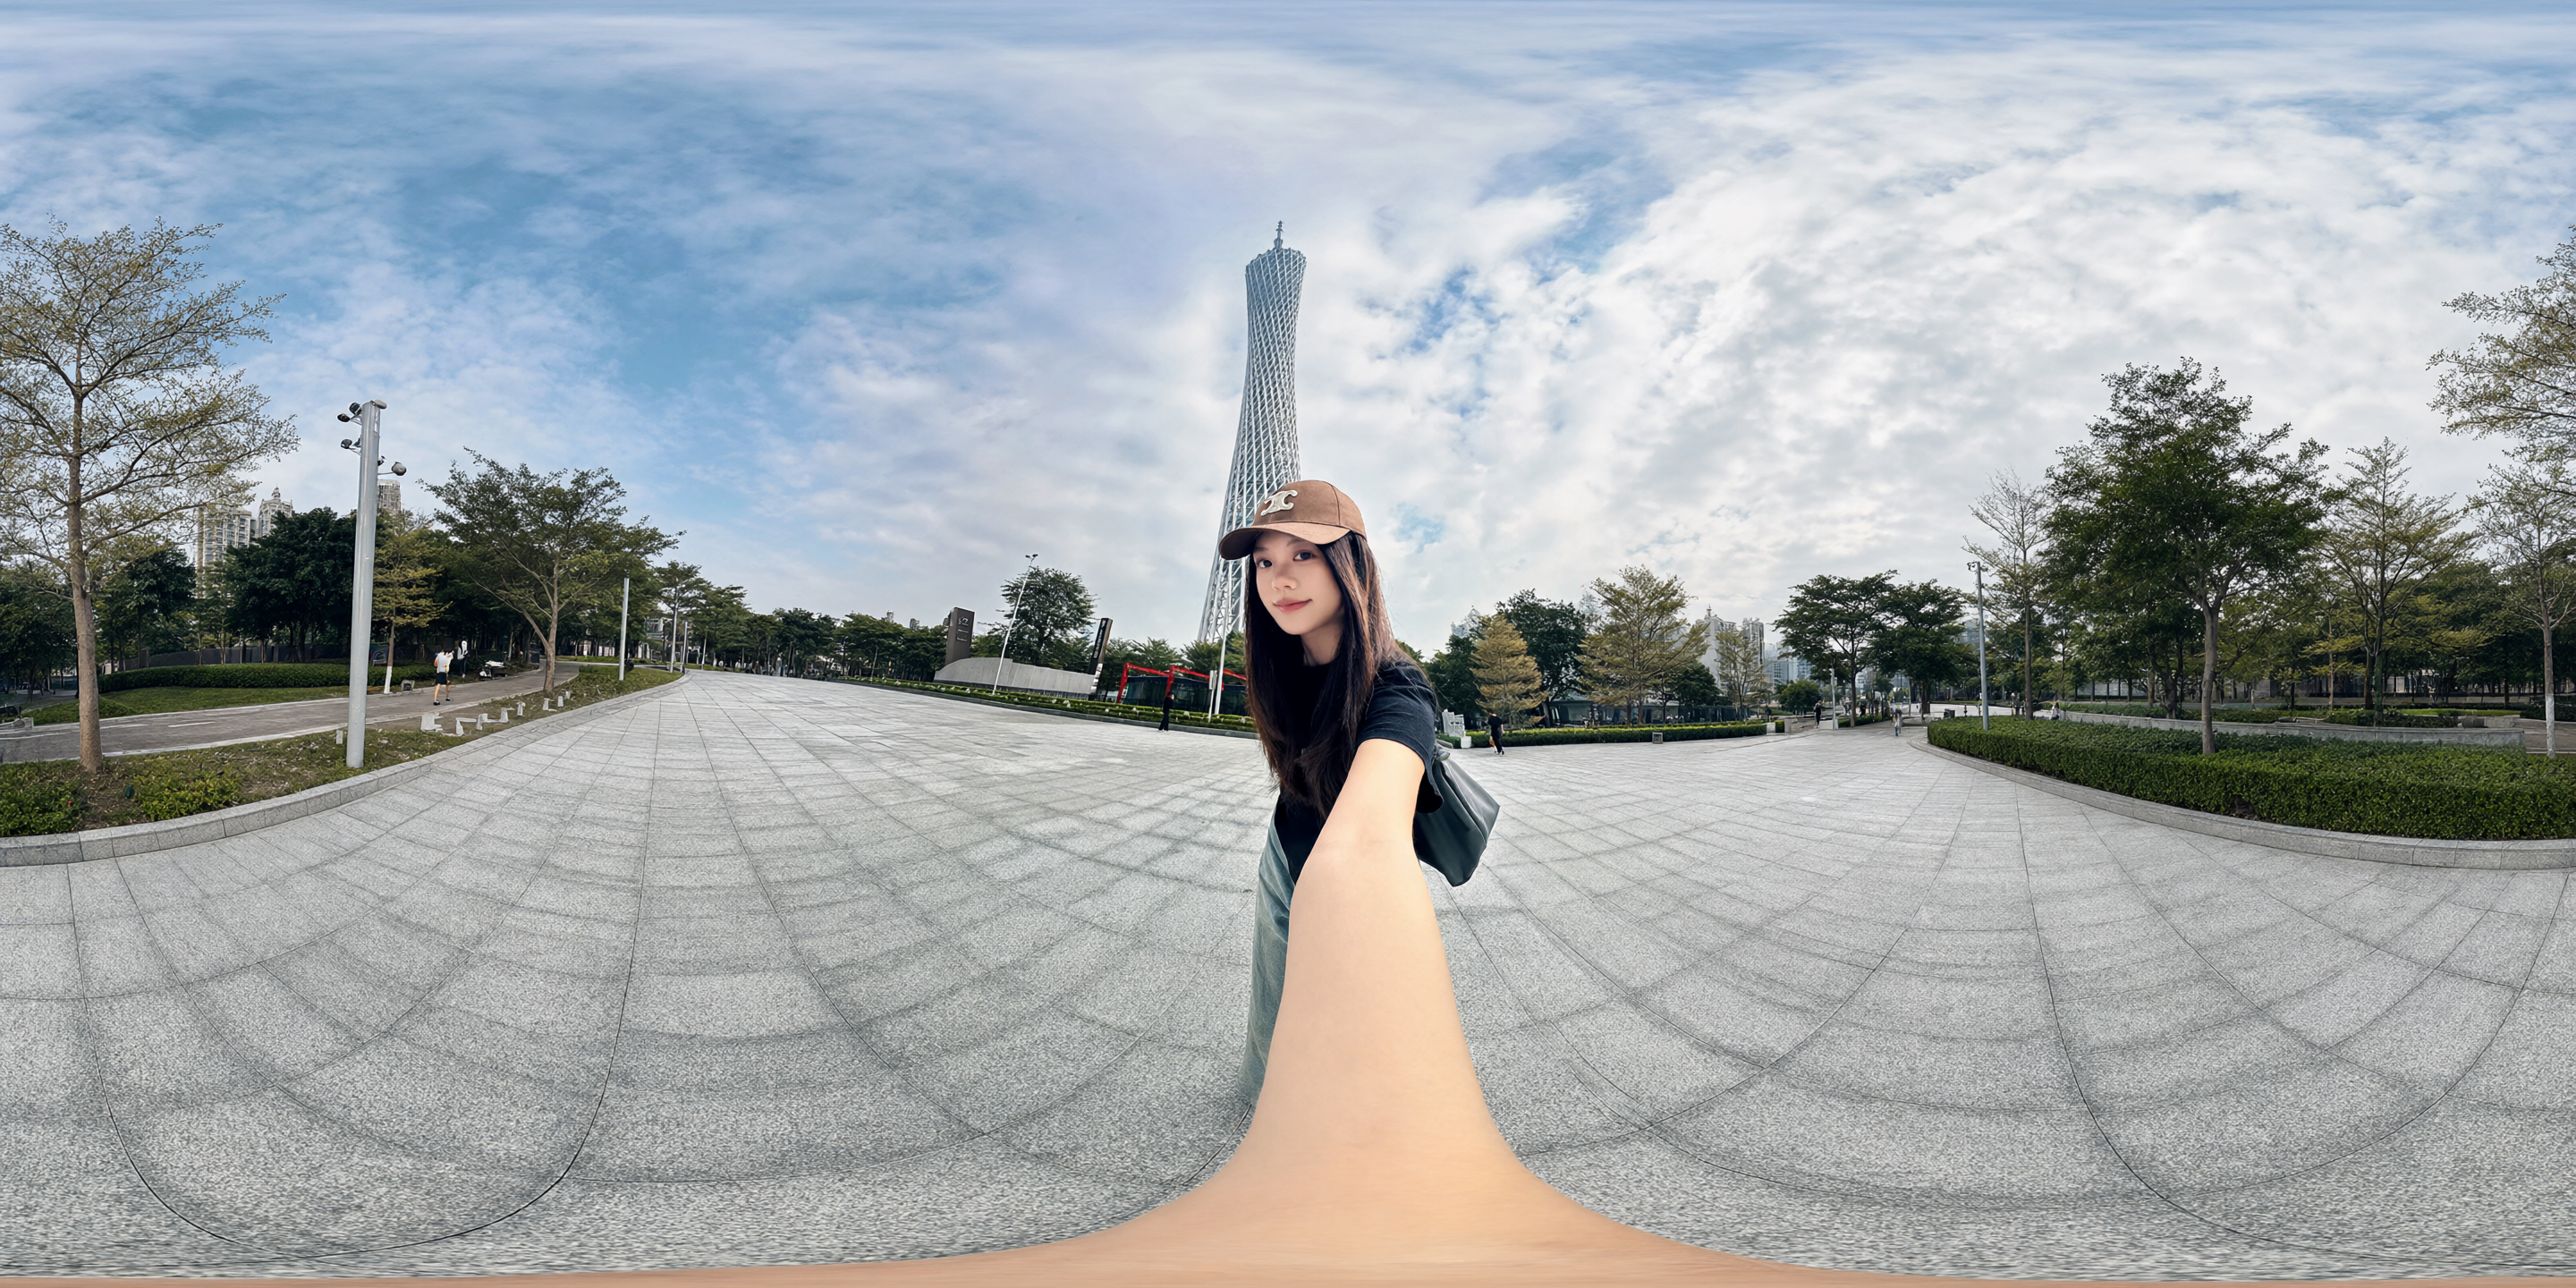
Затем панораму можно рассматривать с разных направлений в инструменте визуализации.
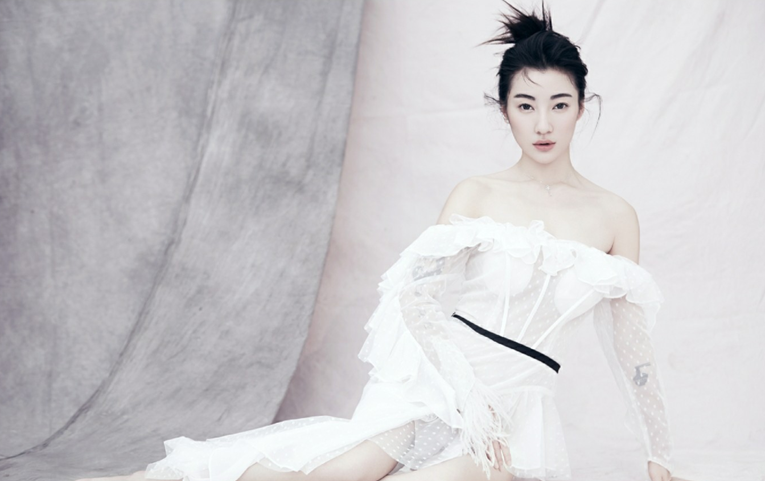
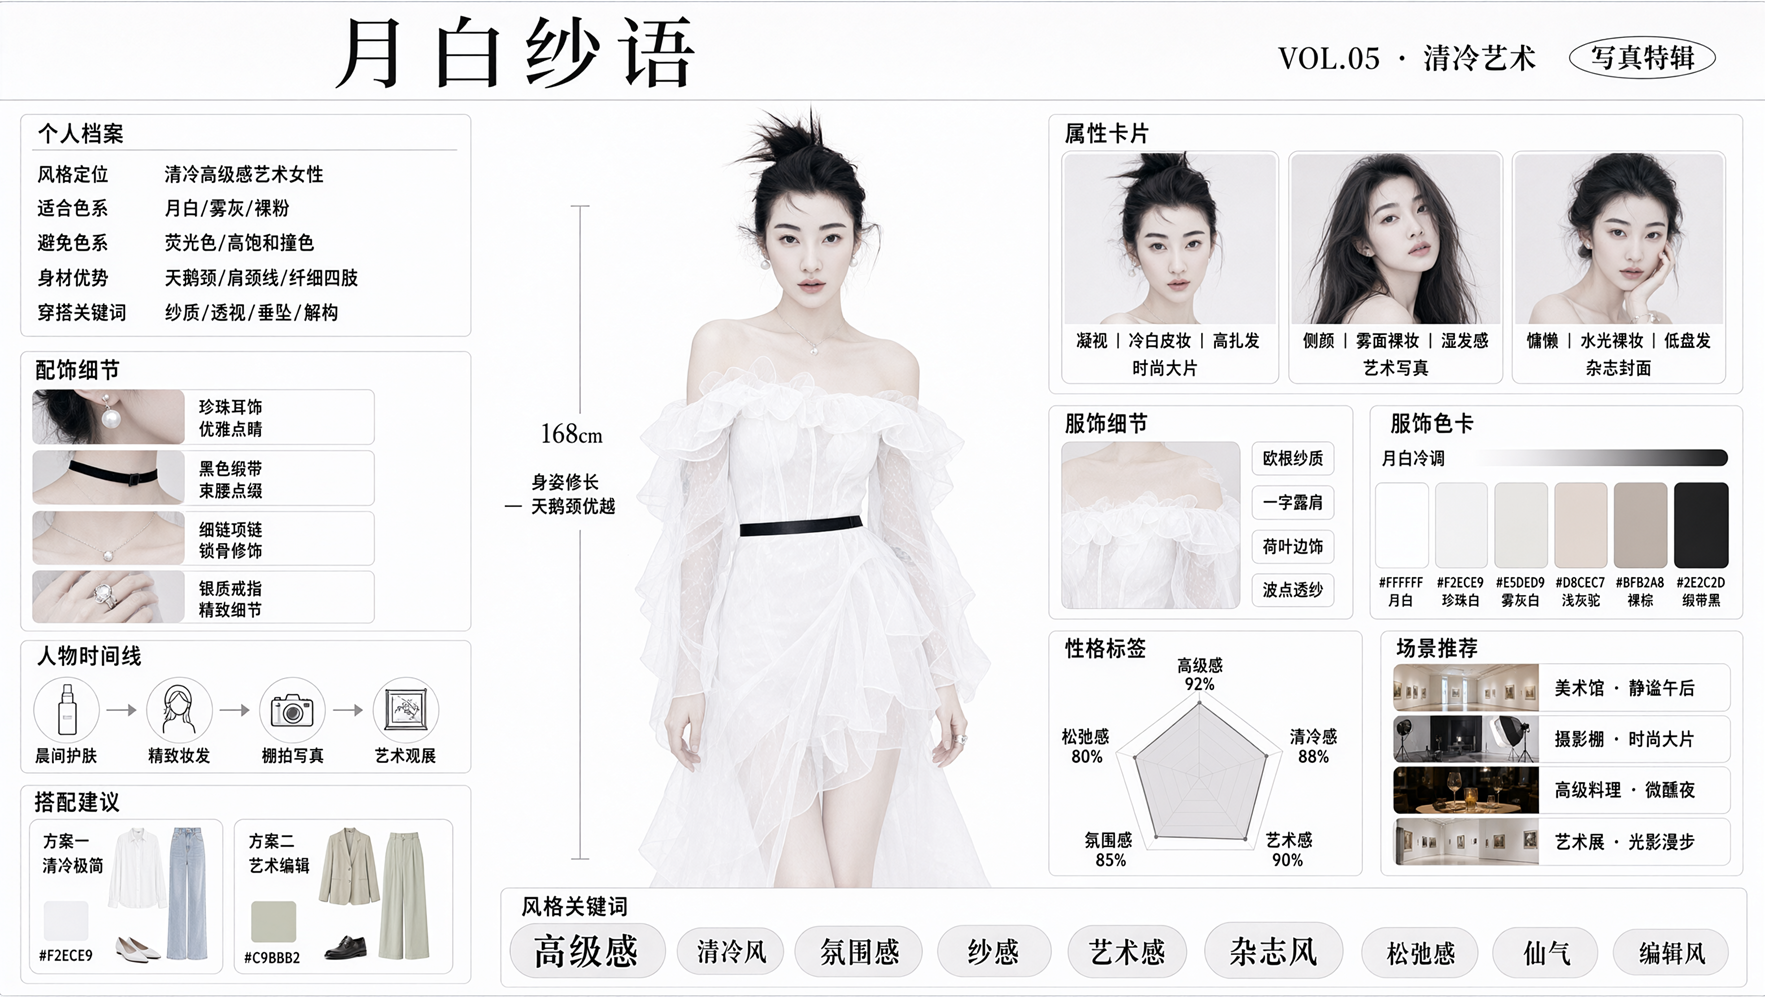
При создании инфографики фотографию модели можно превратить в подробную композицию с большим количеством информации.
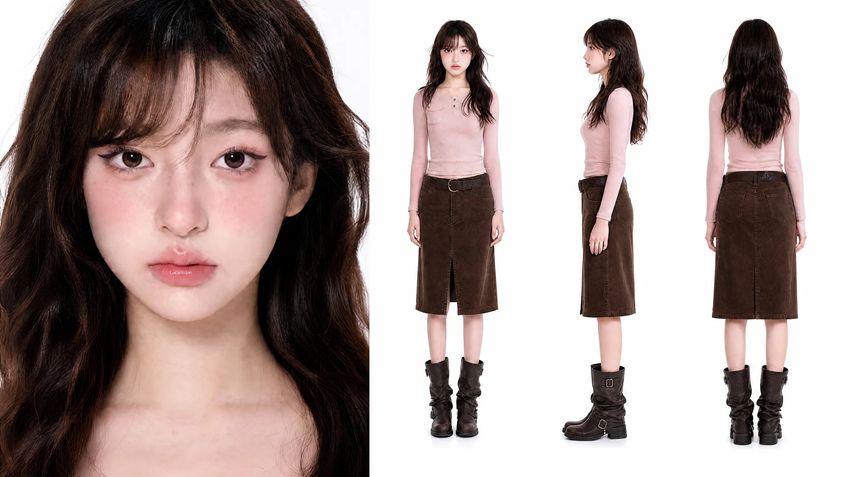
Модель также может превратить референс персонажа в трёх ракурсах в полноценную раскадровку — материал для истории и визуального повествования.
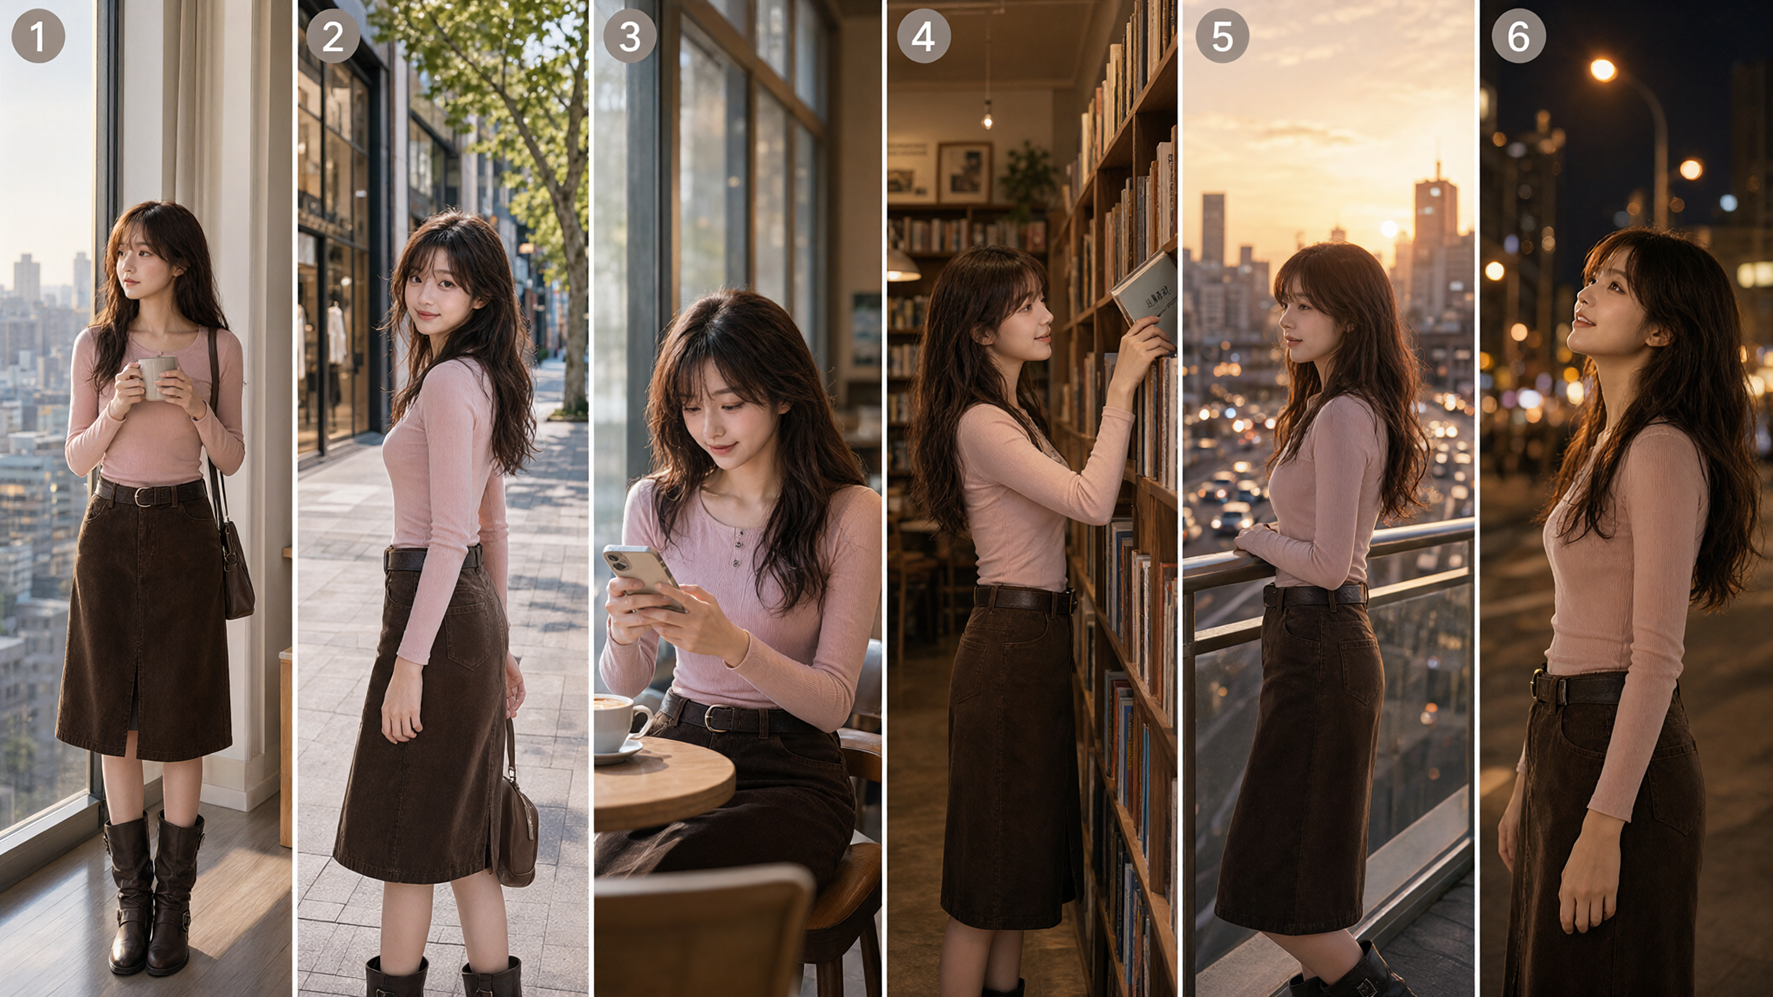
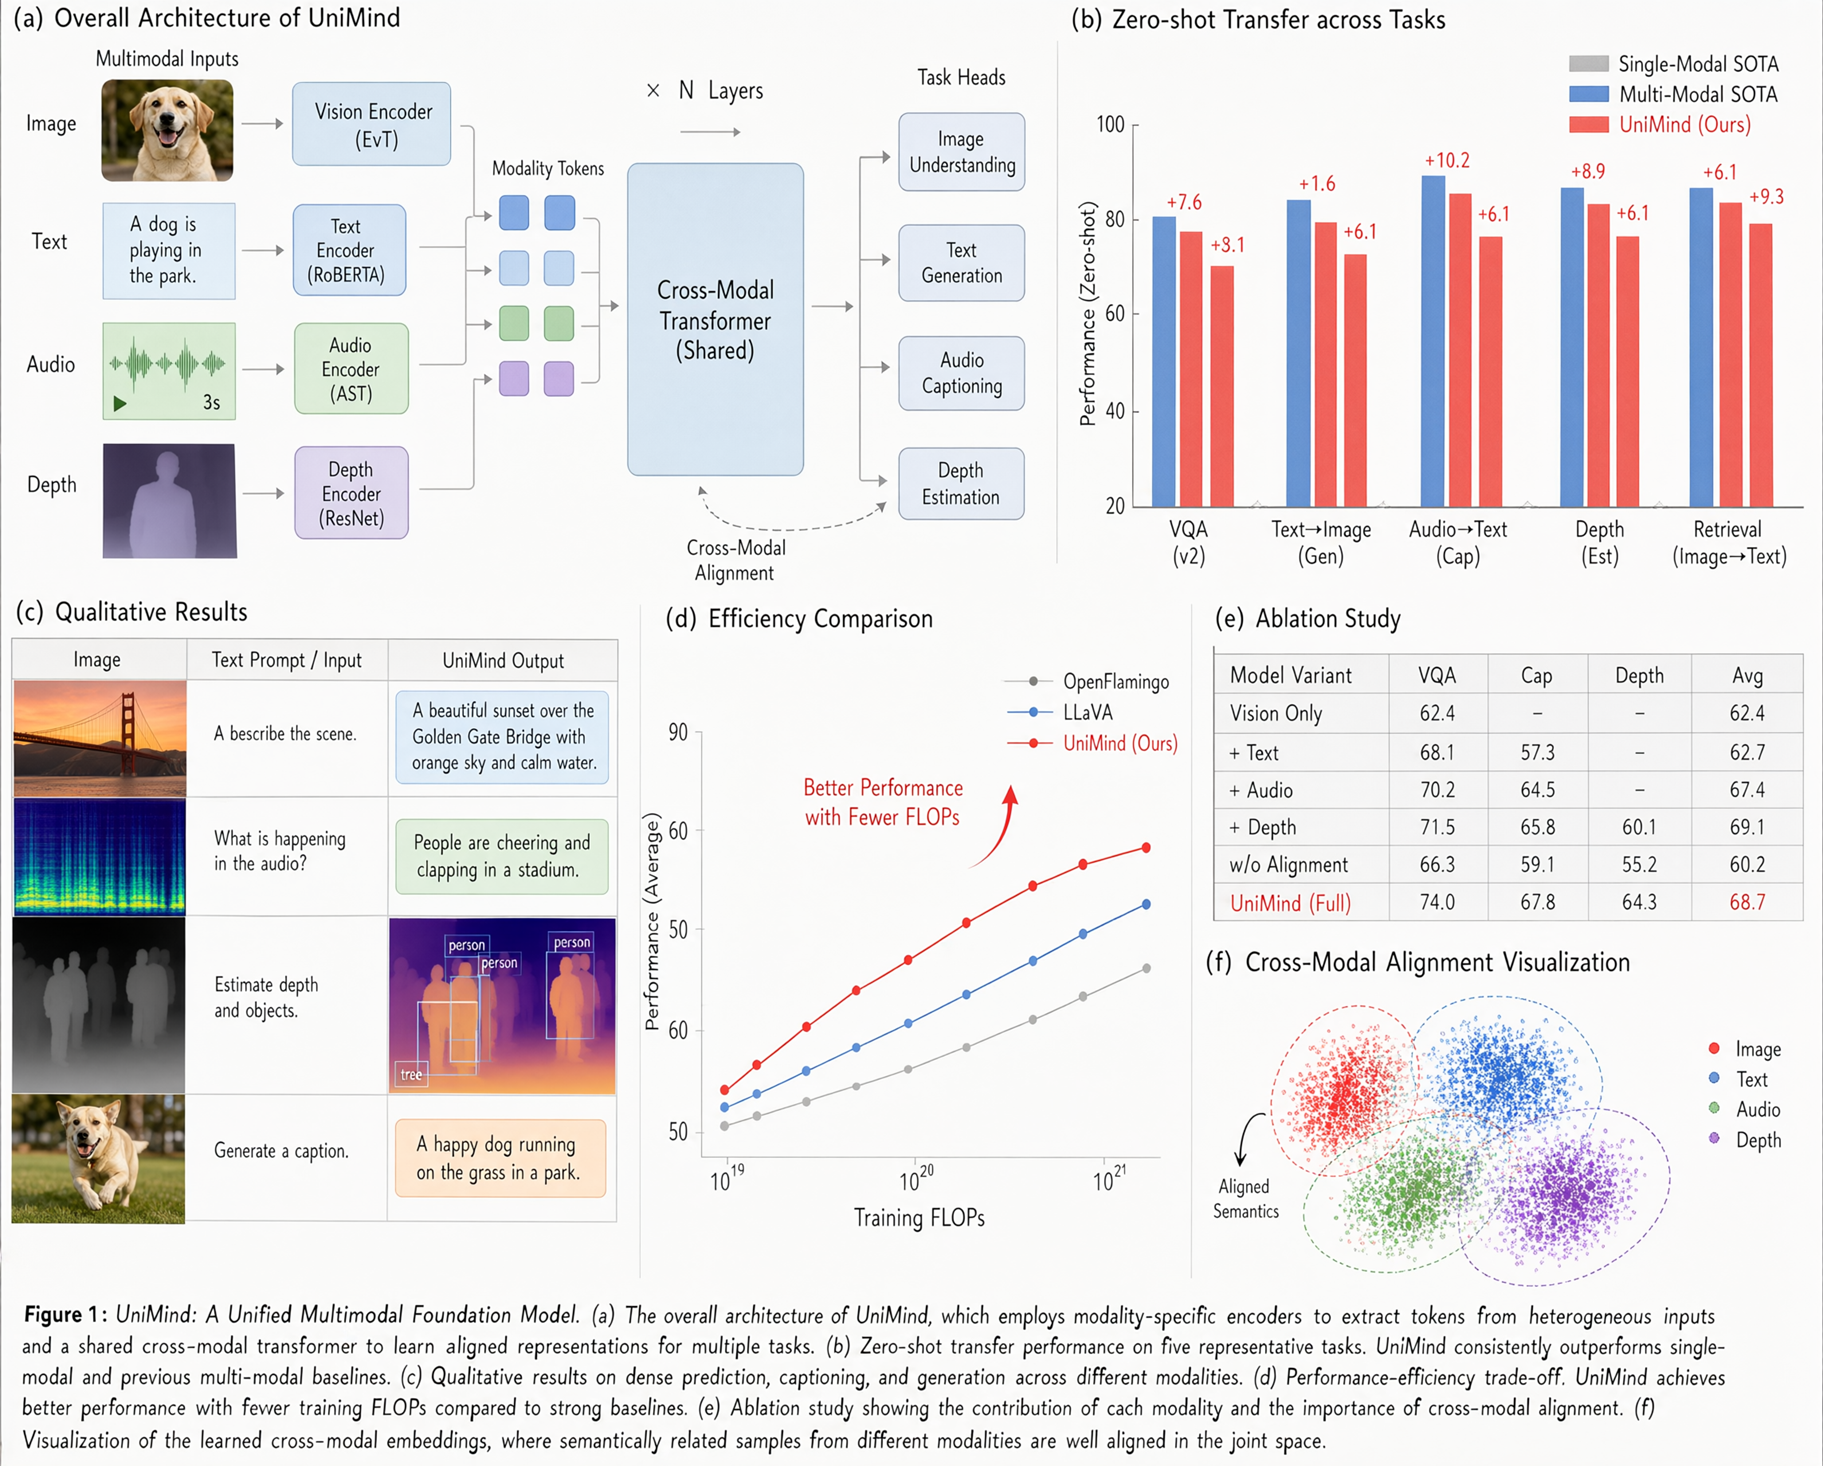
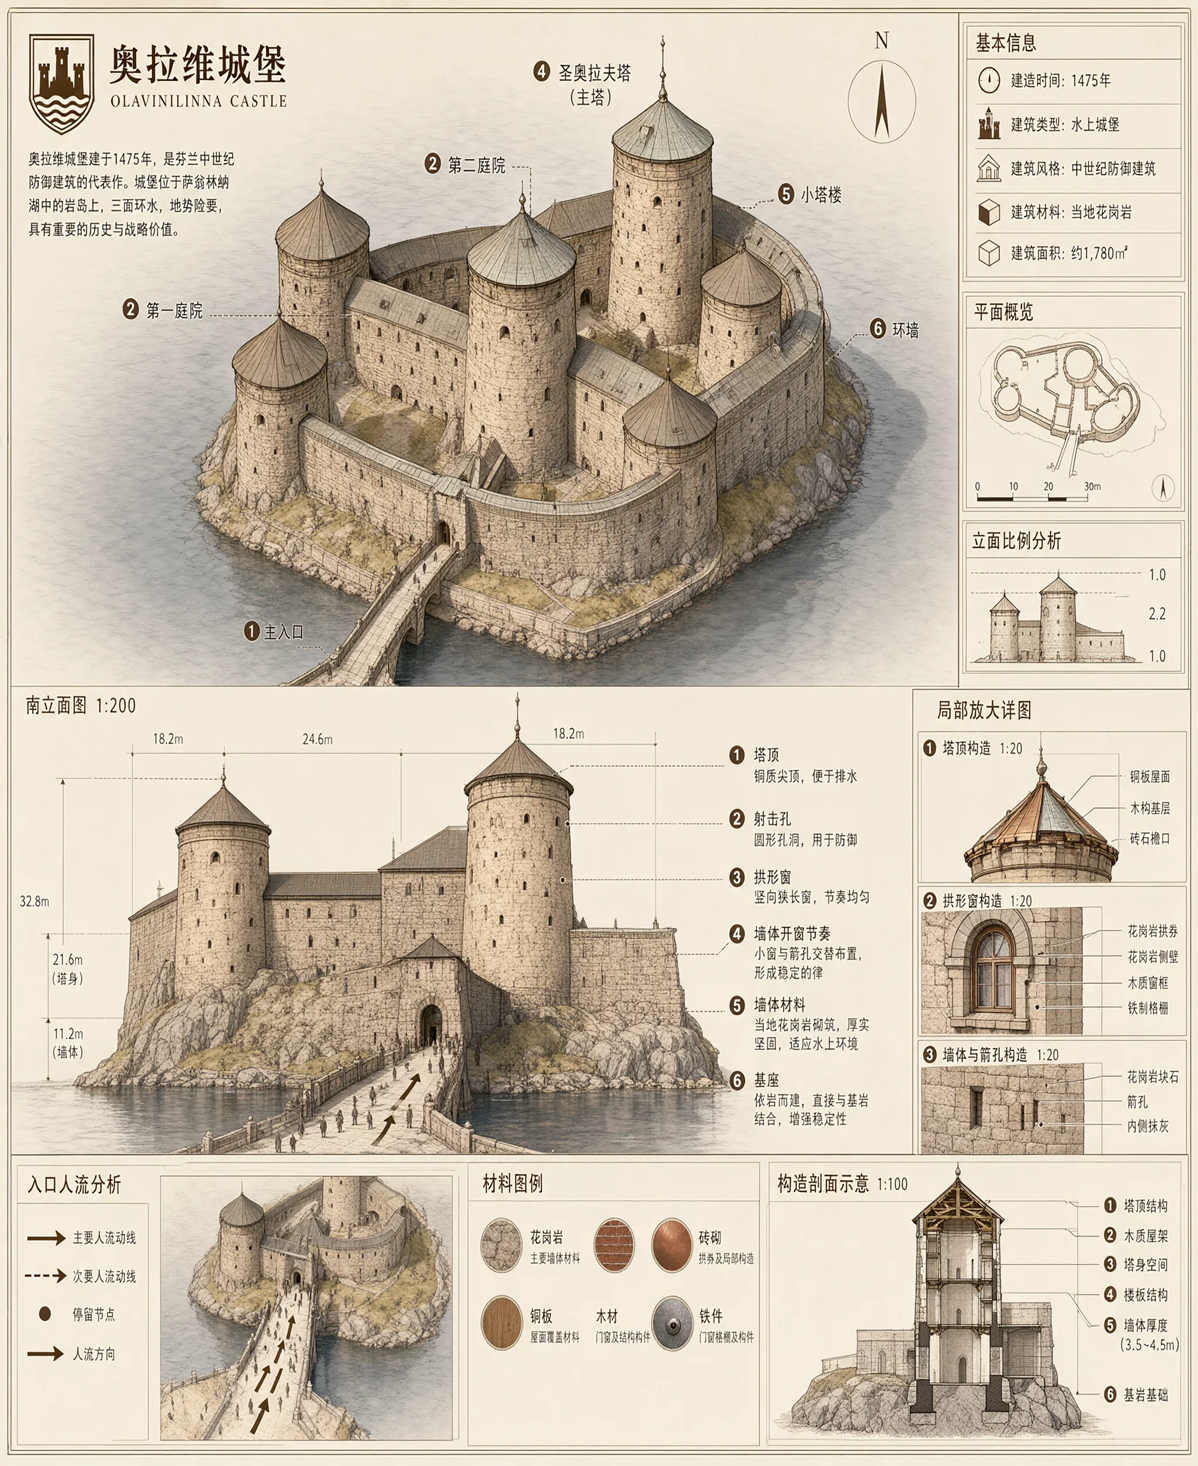
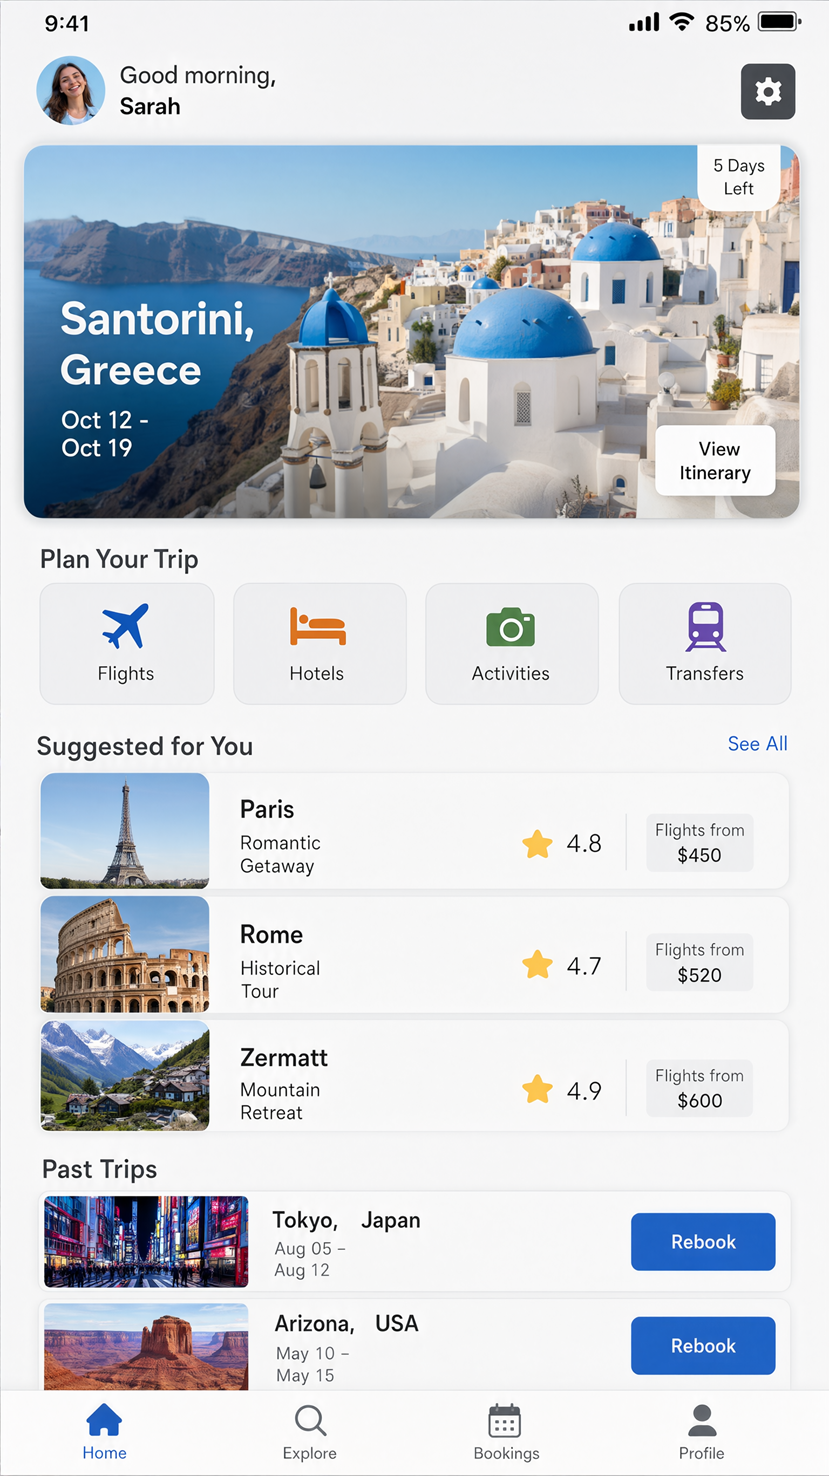
Реалистичные фактуры и более точное визуальное оформление
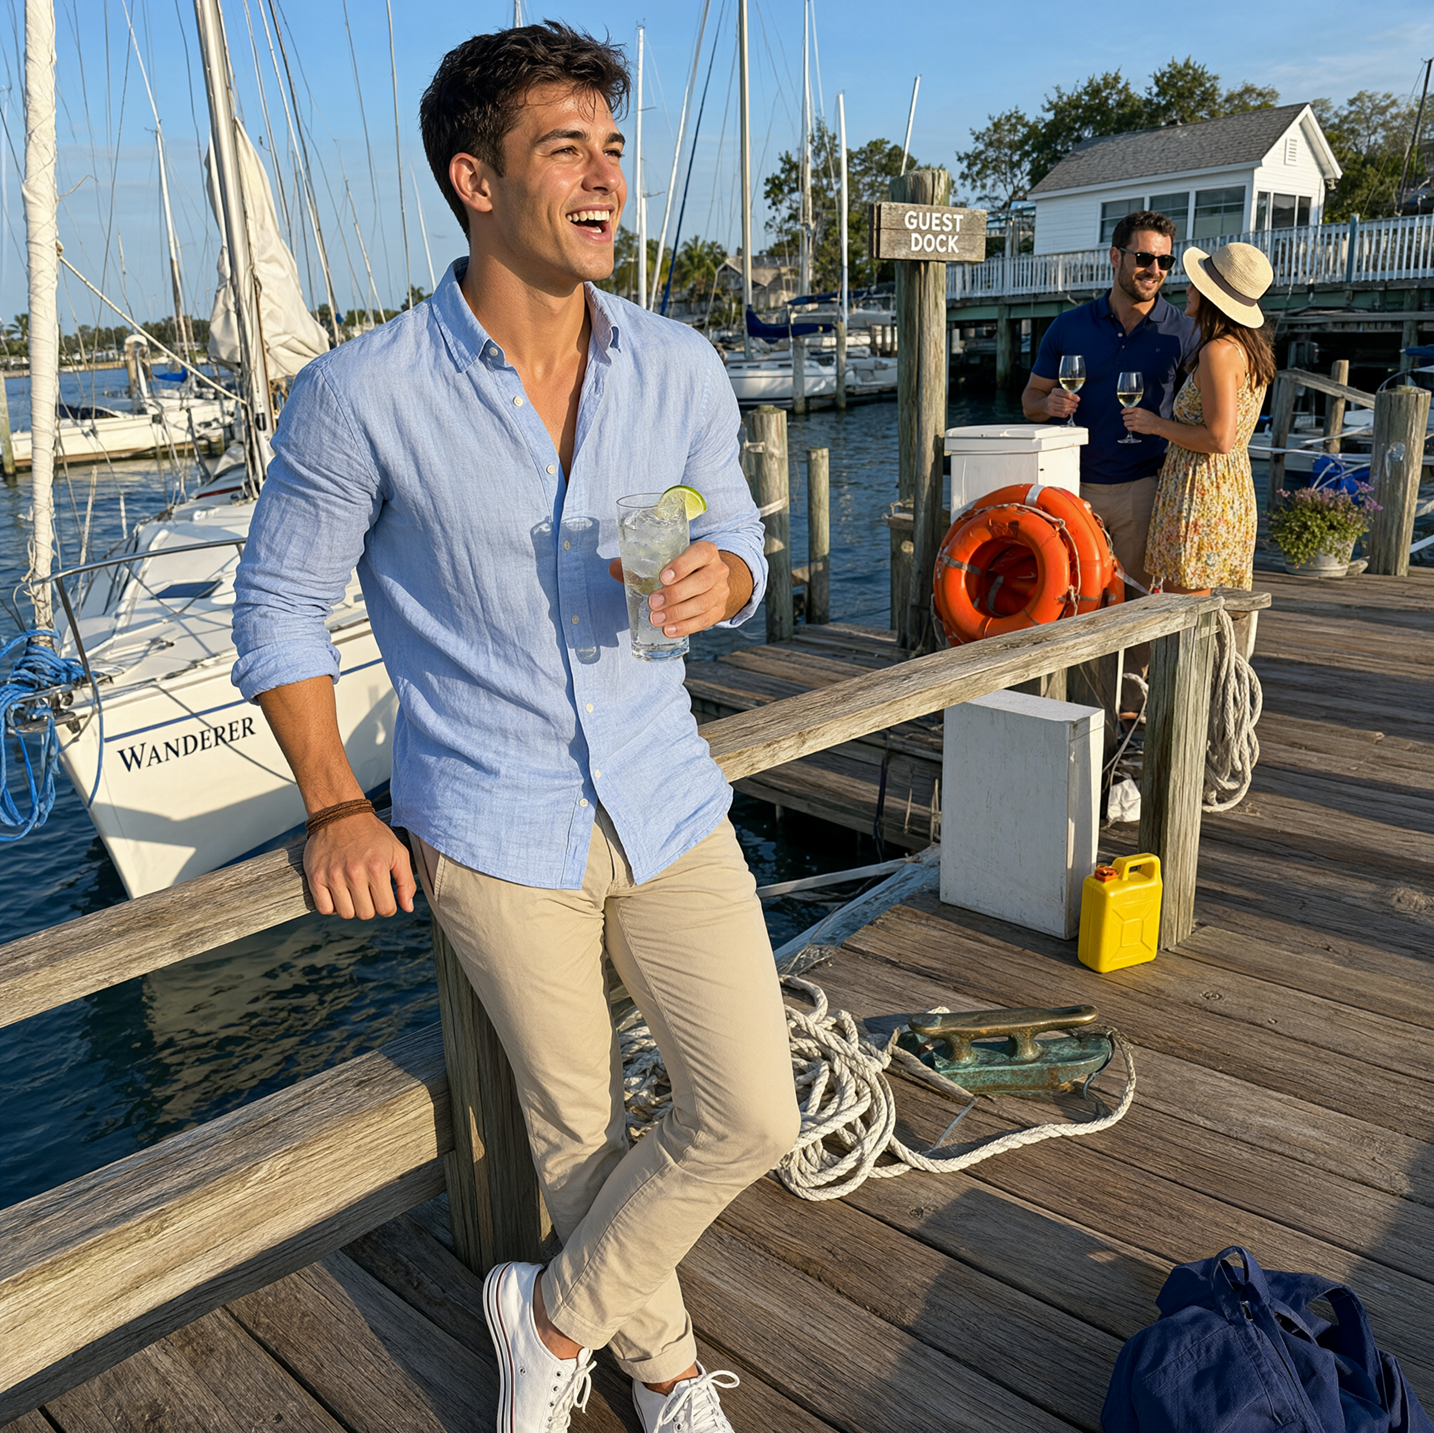
В Qwen-Image-2.1 дополнительно улучшено качество изображений, особенно типографика и портреты. При отрисовке текста учитывается не только само содержание, но и начертание, расположение надписей и их связь с общей композицией. Следующие примеры показывают работу с текстом в разных условиях.
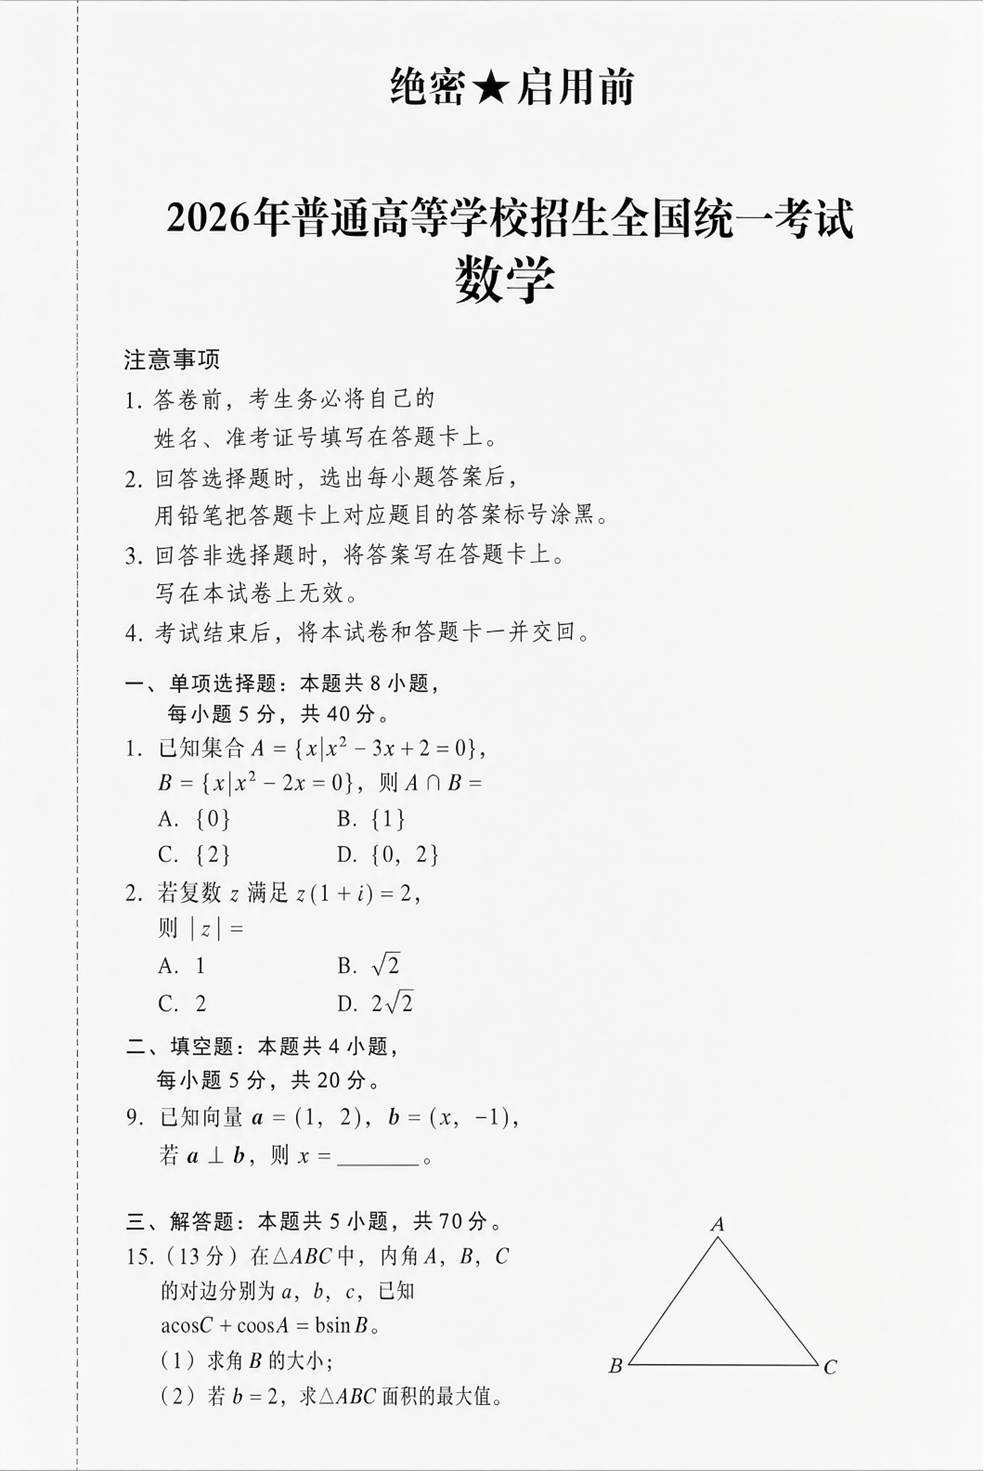
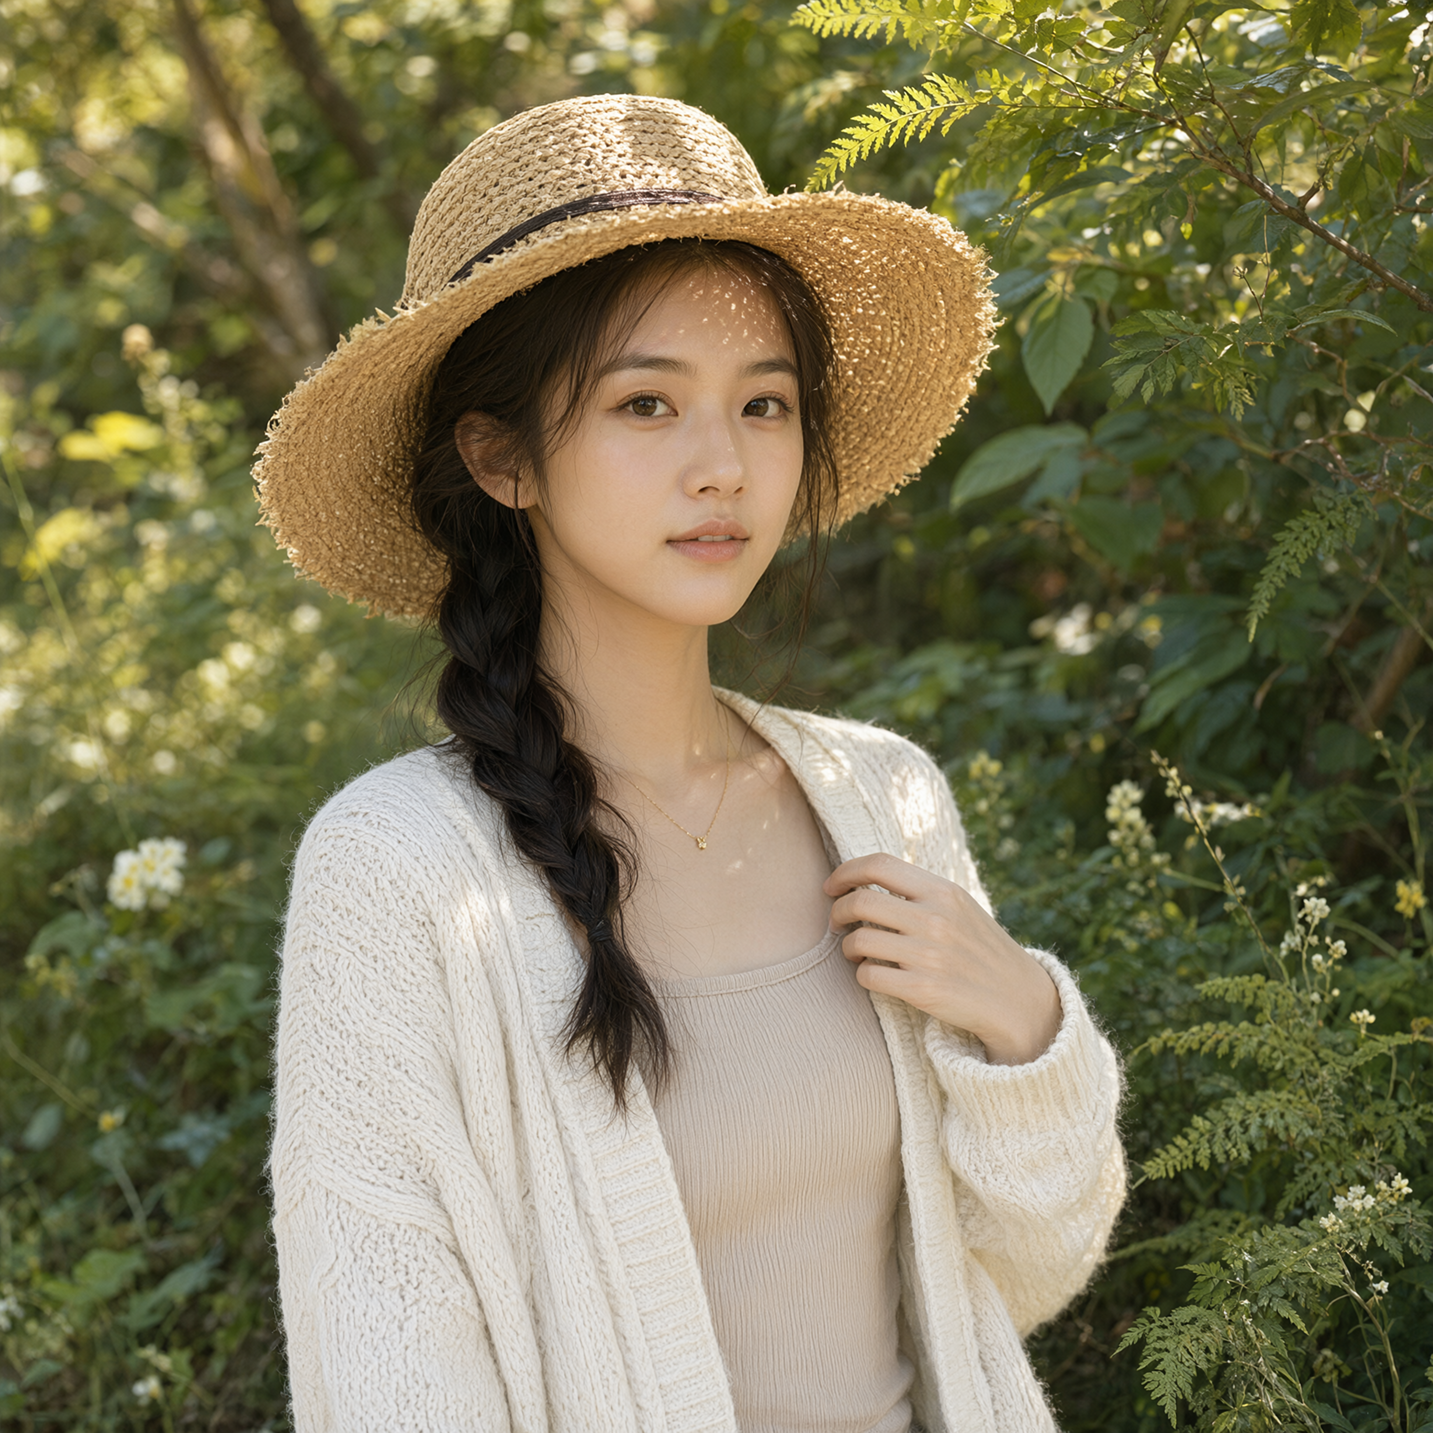
В портретах более точная работа со светом и мелкими деталями делает сгенерированные изображения реалистичнее.
Заключение
Qwen-Image-2.1 с компактной генеративной визуальной частью на 7 миллиардов параметров объединяет создание изображений, поддержку прозрачности и разнообразные возможности редактирования. Более быстрый инференс, до 10 референсов, гибкое локальное редактирование и лучшее сохранение особенностей людей и товаров делают её практичным инструментом для дизайна, создания контента, электронной торговли и визуального повествования.
Надеемся, вам понравится создавать изображения с Qwen-Image-2.1!
Примечание редакции Neurosaver
Выше закончился перевод статьи QwenTeam. График, примеры и выводы о качестве принадлежат разработчикам. Они не означают, что модель безошибочно сохраняет лицо, надписи или детали товара в любой задаче. Видео с капибарами показывает анимацию, собранную из результатов последовательного редактирования, а не доказательство наличия у модели отдельного режима генерации видео.
Есть и существенная оговорка о лицензии: веса опубликованы под Qwen Research License, а не Apache 2.0. В тексте лицензии использование материалов ограничено исследованием и оценкой; для коммерческого применения предусмотрена отдельная лицензия. Условия в официальном репозитории.
Если вы разбираетесь в обработке изображений, материалы Timesaver помогут связать эти примеры с практикой. Базовые приёмы работы с масками и последовательностями обработки можно изучать в разделе ComfyUI. Сам этот перевод не является инструкцией по установке Qwen-Image-2.1 и не подтверждает совместимость с конкретным набором узлов.
Оригинал: Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation — QwenTeam, 20 сентября 2026. Изображения и видео показаны без перерисовки и размещаются на исходном хостинге. Переведены текст, подписи и описания изображений; если оригинальные файлы будут удалены, эти встроенные материалы станут недоступны.
Источник: QwenTeam — оригинальная статья от 20 сентября 2026 ↗
Подписка Neurosaver
Следить за главными AI-новостями
Присылаем только то, что действительно меняет рынок нейросетей: без ежедневного шума, хайпа и случайных пресс-релизов.
